Análisis de costos por ejecución y control de tokens
El costo operativo de un agente LangGraph es un factor crítico en producción. Esta lección detalla cómo calcular y optimizar el gasto asociado al consumo de tokens de los modelos de lenguaje, una métrica directa del uso de recursos y un componente principal del costo de inferencia.
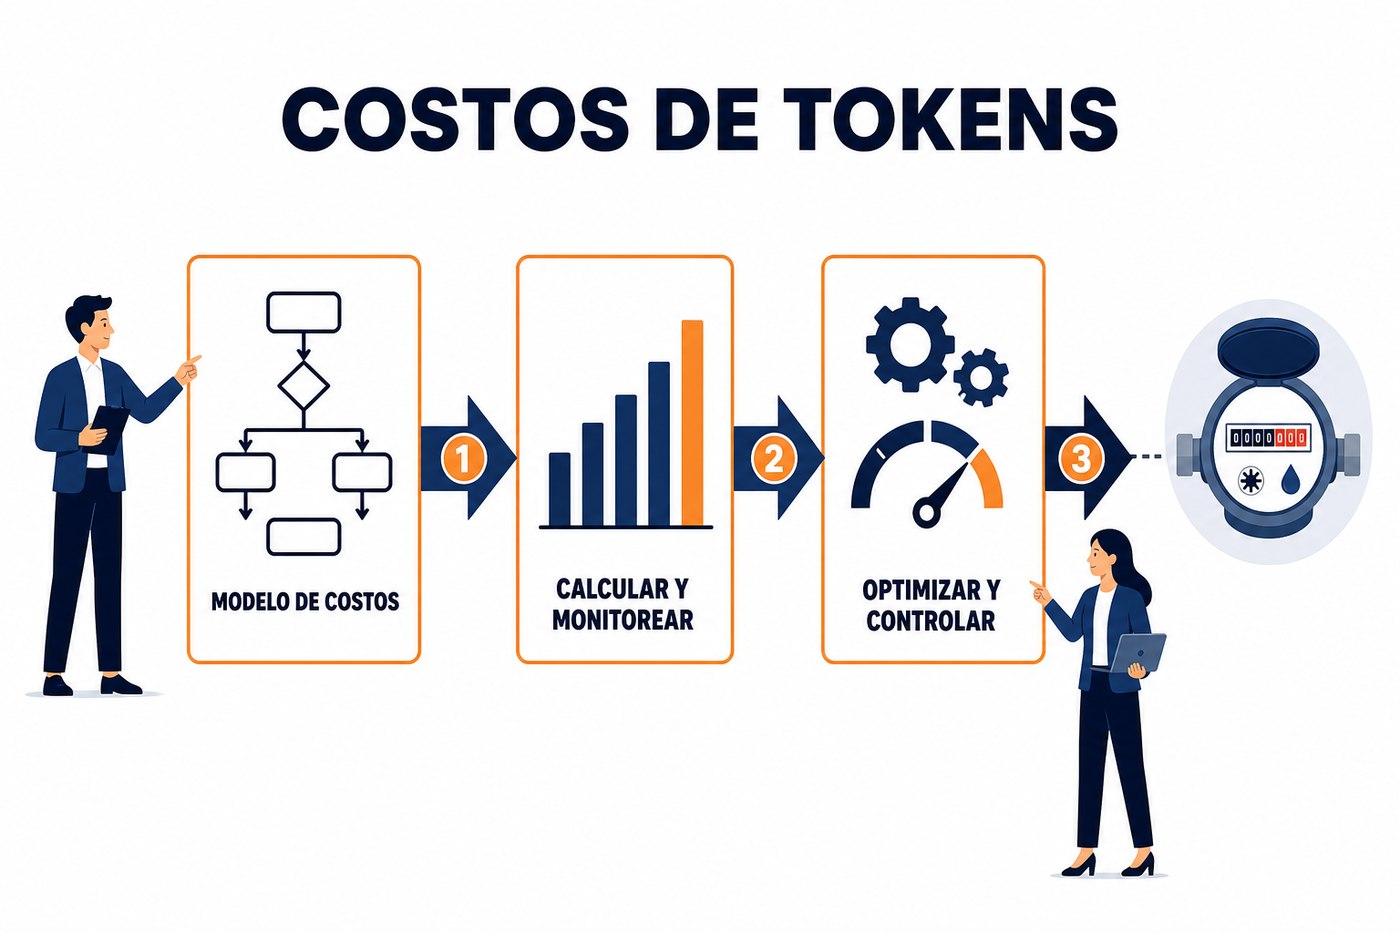
El modelo de costos de los LLM
Los proveedores de modelos de lenguaje grandes (LLM) facturan por el uso de tokens. Existen dos categorías principales de tokens:
- Tokens de entrada (prompt tokens): Son los tokens que el modelo recibe como parte de la solicitud (el prompt, el historial de conversación, las herramientas disponibles, etc.). Generalmente, tienen un costo menor por token.
- Tokens de salida (completion tokens): Son los tokens que el modelo genera como respuesta. Suelen tener un costo mayor por token, ya que representan el trabajo computacional de la inferencia.
Los costos varían significativamente entre modelos (por ejemplo, GPT-3.5 Turbo vs. GPT-4o), versiones del mismo modelo y proveedores. Es fundamental consultar la tabla de precios actualizada del proveedor específico que se esté utilizando. Un agente LangGraph, al encadenar múltiples llamadas a LLM, puede acumular un consumo considerable de tokens en una sola ejecución.
Cálculo y monitoreo del costo por ejecución
Para calcular el costo de una ejecución, se necesita el conteo de tokens de entrada y salida para cada llamada a LLM dentro del grafo, y los precios unitarios de cada modelo utilizado. Herramientas como LangSmith (o sus equivalentes internos) son esenciales para esto. LangSmith registra automáticamente el conteo de tokens para cada llamada a LLM, lo que permite un cálculo granular.
El costo total de una ejecución (trace) se obtiene sumando el costo de cada llamada a LLM:
- Costo_llamada = (tokens_entrada * precio_entrada) + (tokens_salida * precio_salida)
- Costo_total_ejecución = Σ Costo_llamada
No asuma que todos los modelos tienen el mismo precio por token o que los precios son estáticos. Verifique las tarifas del proveedor antes de estimar costos y establezca un proceso para revisar estas tarifas periódicamente, ya que pueden cambiar sin previo aviso.
En LangSmith, puede configurar los precios de los modelos en la sección de configuración para que calcule automáticamente el costo por trace. Esto ofrece una visión directa del impacto económico de cada flujo de trabajo.
Estrategias de optimización de tokens
La optimización de tokens se traduce directamente en ahorro de costos. Las estrategias incluyen:
- Selección de modelo: Utilice el modelo más pequeño y económico que cumpla con los requisitos de calidad. No siempre se necesita GPT-4o para tareas sencillas. Evalúe alternativas como los modelos de código abierto (Llama, Mixtral) si el despliegue local es viable y justifica la inversión en infraestructura.
- Ingeniería de prompts: Refine los prompts para ser concisos y claros. Elimine información redundante o instrucciones ambiguas que puedan llevar a respuestas más largas de lo necesario. Utilice ejemplos concisos en few-shot prompting.
- Gestión de historial de conversación: Implemente estrategias de resumen o truncamiento del historial para evitar enviar conversaciones completas en cada turno. Técnicas como el resumen de ventanas deslizantes o la condensación del historial reducen los tokens de entrada.
- Funciones y herramientas: Diseñe funciones y herramientas que devuelvan solo la información esencial. Evite pasar objetos JSON completos o resultados de bases de datos sin filtrar. La granularidad de las herramientas impacta el tamaño de las llamadas de función y sus resultados.
- Caché (caching): Implemente una capa de caché para respuestas repetitivas o para pasos intermedios del grafo que no cambian con frecuencia. Esto evita llamadas innecesarias a LLM.
- Batching de solicitudes: Si es posible, agrupe múltiples solicitudes de inferencia en una sola llamada al LLM para aprovechar eficiencias del proveedor, aunque esto es más complejo de implementar en un grafo dinámico.
Control de tokens y límites
Además del costo, el control de tokens es crucial para evitar exceder los límites de contexto de los modelos (context window) y para gestionar la latencia. Un prompt excesivamente largo puede ser rechazado o truncado por el modelo, o puede aumentar drásticamente el tiempo de respuesta.
- Tokenizadores: Utilice el tokenizador específico del modelo (ej. `tiktoken` para OpenAI) para estimar el conteo de tokens antes de enviar la solicitud. Esto permite aplicar lógica de truncamiento o resumen proactivamente.
- Límites en el grafo: Implemente nodos en el grafo que verifiquen el tamaño de los prompts o las respuestas intermedias. Si un segmento excede un umbral, se puede activar una acción (ej. resumir, truncar, solicitar confirmación al usuario, o generar un error controlado).
- Monitoreo de umbrales: Configure alertas en su sistema de observabilidad (LangSmith, Prometheus, Grafana) para cuando el consumo de tokens por ejecución supere un umbral definido. Esto puede indicar un bucle infinito, un prompt mal diseñado o un uso inesperado del agente.
from tiktoken import encoding_for_model

def count_tokens(text: str, model_name: str = "gpt-4o") -> int:
    """Cuenta tokens usando el codificador específico del modelo."""
    try:
        encoding = encoding_for_model(model_name)
    except KeyError:
        print(f"Advertencia: No se encontró codificador para {model_name}, usando 'cl100k_base'.")
        encoding = encoding_for_model("gpt-4o") # Fallback
    return len(encoding.encode(text))
Aplicación práctica: qué hacer el lunes
- Identifique los modelos en uso: Liste todos los modelos de LLM que su agente LangGraph utiliza en producción. Investigue sus precios actuales por token de entrada y salida.
- Habilite el monitoreo de costos: Si usa LangSmith, configure los precios de los modelos para que el costo se muestre en cada trace. Si usa una solución propia, implemente la lógica para calcular y registrar los tokens y el costo por ejecución.
- Analice los traces más costosos: Utilice su herramienta de observabilidad para identificar las 10-20 ejecuciones (traces) más caras de su agente. Revise sus trayectorias para entender qué nodos o interacciones están generando el mayor consumo de tokens.
- Priorice optimizaciones: Seleccione una o dos estrategias de optimización (ej. resumen de historial, mejora de prompts en un nodo específico) y aplíquelas al componente más costoso. Mida el impacto en el consumo de tokens y el costo total. Repita el ciclo.
No hay comentarios por ahora.
para ser el primero en comentar.