Bases vectoriales y búsqueda por similitud
Los embeddings se guardan en una base vectorial que permite buscar los vecinos más cercanos a una consulta.
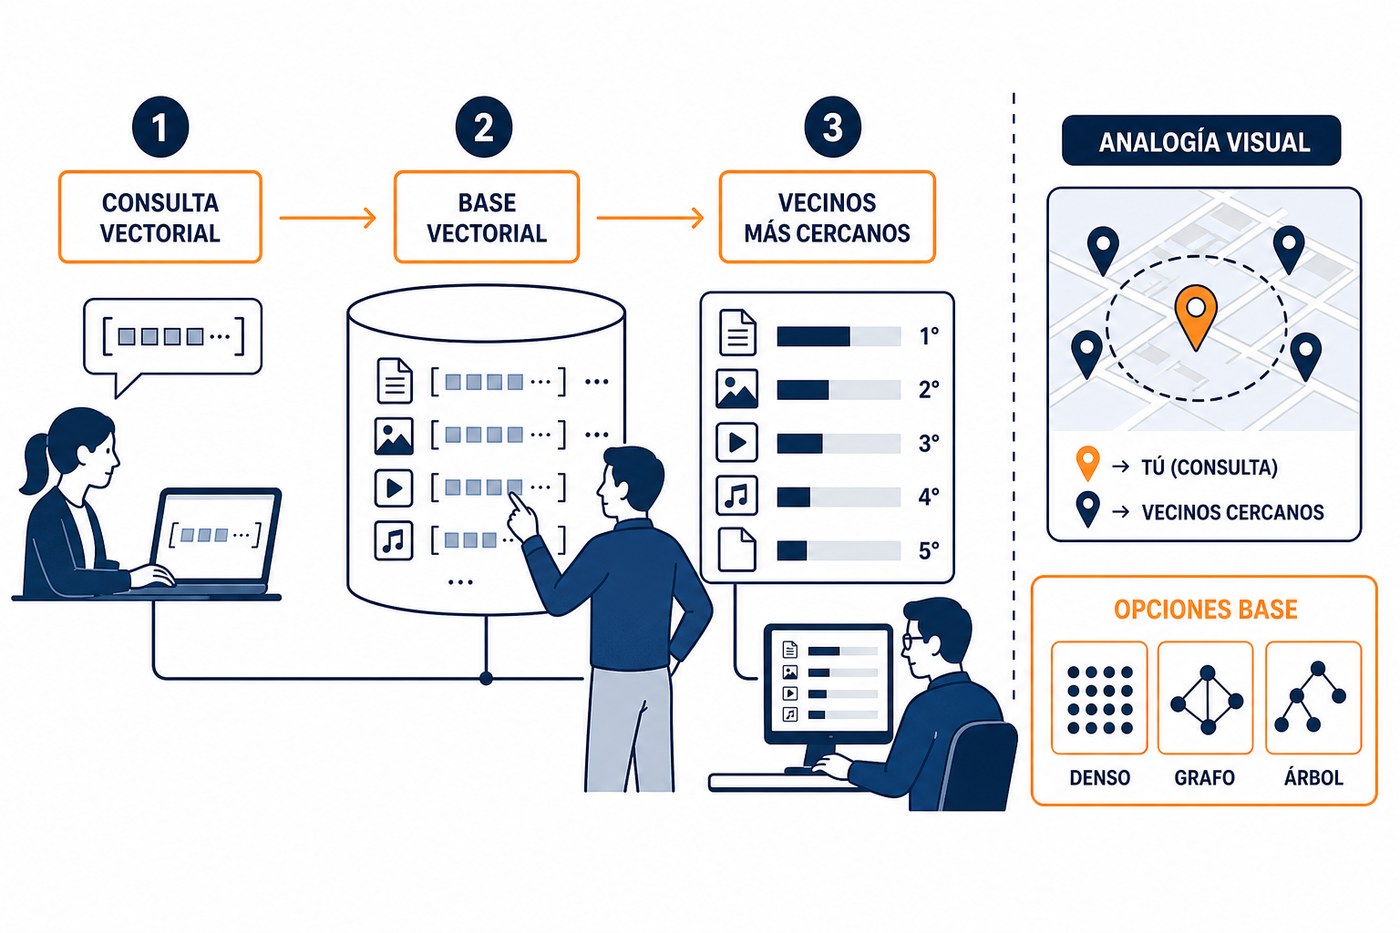
Cómo funciona la búsqueda
- La pregunta se convierte en vector.
- Se calcula similitud coseno (o distancia) contra todos los chunks.
- Se devuelven los top-k más parecidos.
Opciones de base
- Chroma: ligera, embebida, la que usa INT.
- FAISS (Meta): rápida, en memoria.
- pgvector: extension de PostgreSQL.
- Qdrant / Weaviate: servicios dedicados con filtros y escalado.
ELEGIR SEGÚN ESCALA
pocos miles de docs → Chroma/FAISS. Millones + filtros por metadatos → Qdrant/pgvector.
Calificación
No hay comentarios por ahora.
para ser el primero en comentar.