Conceptos de RAG (Retrieval Augmented Generation)
La Generación Aumentada por Recuperación (RAG) es una técnica fundamental para mejorar la precisión y relevancia de las respuestas de los modelos de lenguaje. Permite a los modelos acceder a información externa, actualizada y específica, superando las limitaciones de su conocimiento pre-entrenado y evitando alucinaciones. RAG es un componente crítico para implementar soluciones de IA generativa en entornos corporativos.
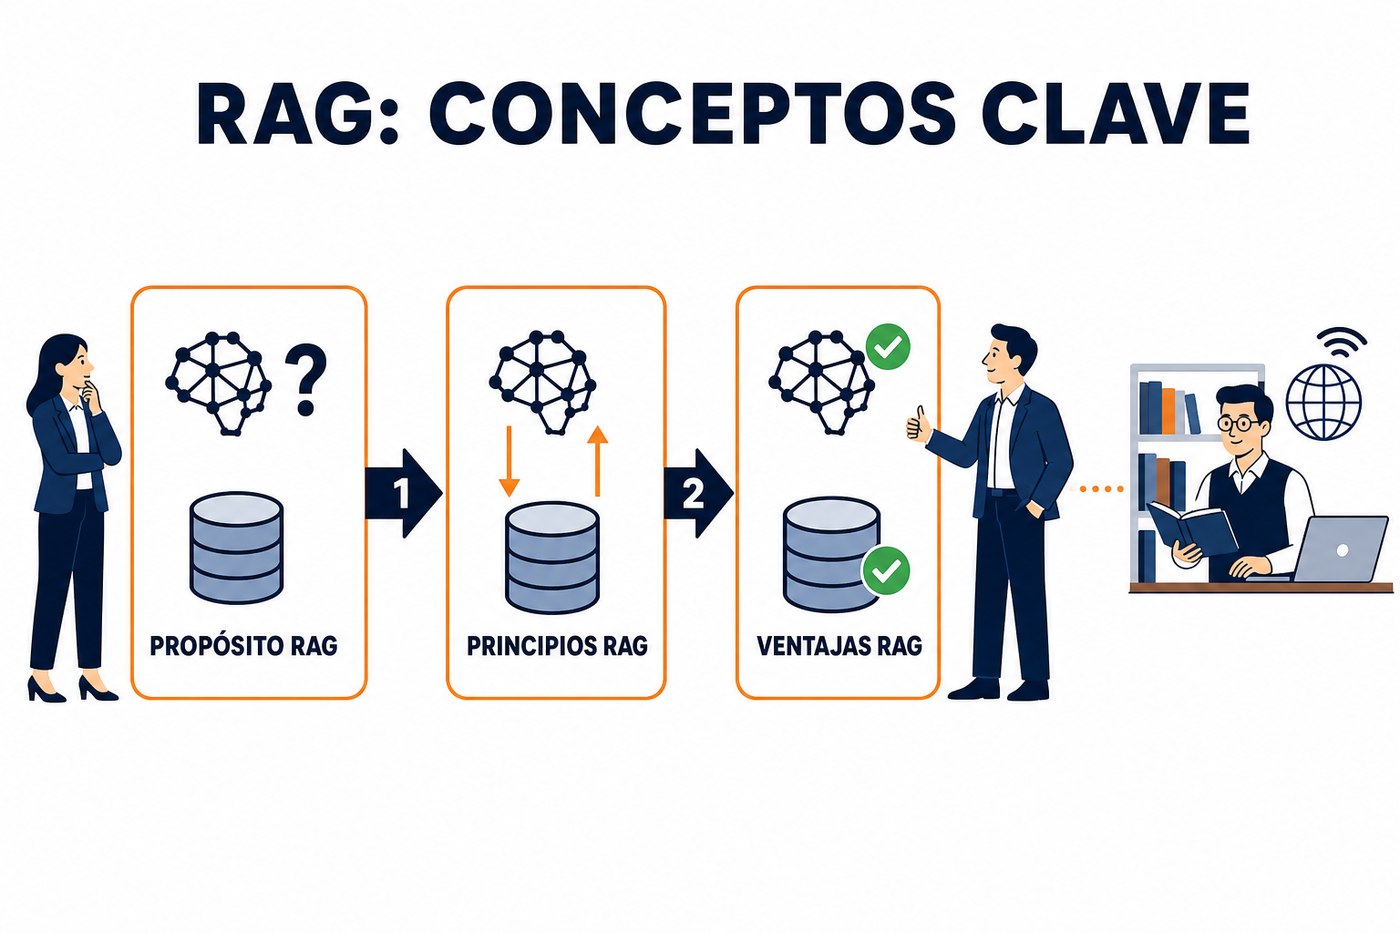
Propósito de RAG: Superar las limitaciones de los LLM
Los Modelos de Lenguaje Grandes (LLM) son potentes, pero su conocimiento está limitado por los datos con los que fueron entrenados. Esto presenta dos problemas operativos clave:
- Conocimiento obsoleto: La información en la que se basan puede no ser actual. Un LLM entrenado hace un año no conocerá los eventos o datos posteriores a su fecha de corte de entrenamiento.
- Falta de especificidad: No tienen acceso a datos internos o propietarios de una organización (documentos técnicos, bases de datos de clientes, manuales de productos, etc.).
- Alucinaciones: Cuando un LLM no tiene la información necesaria, tiende a "inventar" respuestas plausibles pero incorrectas, lo que es inaceptable en aplicaciones empresariales.
RAG aborda estas limitaciones al proporcionar a los LLM acceso a una fuente de datos autorizada y externa en tiempo real, antes de generar una respuesta. Esto asegura que la generación se base en hechos verificables y relevantes para el contexto específico del usuario o la organización.
Principios operativos de RAG: Recuperación y Generación
El proceso de RAG se divide conceptualmente en dos fases principales que ocurren antes de que el LLM genere su respuesta final:
- Fase de Recuperación (Retrieval): Cuando un usuario envía una consulta, el sistema RAG primero busca y recupera documentos o fragmentos de texto relevantes de una base de conocimiento externa. Esta base puede ser un índice de búsqueda, una base de datos vectorial, una colección de documentos, etc. La recuperación se basa en la similitud semántica entre la consulta y el contenido de la base de conocimiento.
- Fase de Aumento (Augmentation) y Generación (Generation): Los fragmentos de información recuperados se combinan con la consulta original del usuario para formar un prompt aumentado. Este prompt se envía al LLM. El LLM utiliza esta información contextual adicional para generar una respuesta más precisa, relevante y libre de alucinaciones.
En esencia, RAG convierte el LLM en un experto que consulta una biblioteca antes de responder, en lugar de solo depender de su memoria.
Componentes clave de un sistema RAG
Para implementar RAG, se requieren varios componentes interconectados:
- Base de conocimiento (Knowledge Base): Es el repositorio de datos externos que el LLM consultará. Puede ser estructurada (bases de datos) o no estructurada (documentos, PDFs, páginas web, transcripciones).
- Procesamiento de datos (Data Processing): Los datos de la base de conocimiento deben ser procesados para facilitar su recuperación. Esto incluye la división en fragmentos (chunks), la limpieza, y la creación de embeddings (representaciones vectoriales numéricas) que capturan el significado semántico del texto.
- Almacén vectorial (Vector Store): Un tipo de base de datos optimizada para almacenar y buscar embeddings. Permite encontrar rápidamente los fragmentos de texto más similares a la consulta del usuario, basándose en la distancia entre sus vectores.
- Motor de búsqueda o recuperador (Retriever): La lógica que toma la consulta del usuario, la convierte en un embedding, y la usa para buscar los fragmentos más relevantes en el almacén vectorial.
- Orquestador (Orchestrator): Coordina el flujo de trabajo: recibe la consulta, invoca al recuperador, construye el prompt aumentado y lo envía al LLM. También puede manejar la lógica de re-intento o la interacción con múltiples herramientas.
Ventajas operativas de RAG
- Precisión mejorada: Las respuestas se basan en información verificable, reduciendo las alucinaciones.
- Relevancia contextual: Se utiliza información específica del dominio o de la empresa, haciendo las respuestas más útiles.
- Actualización dinámica: La base de conocimiento puede actualizarse de forma independiente al LLM, manteniendo la información fresca sin necesidad de re-entrenar el modelo.
- Transparencia y trazabilidad: Es posible citar las fuentes de donde se extrajo la información, lo que permite a los usuarios verificar la respuesta.
- Reducción de costos de entrenamiento: Evita la necesidad de fine-tuning continuo del LLM para incorporar nuevos datos, lo cual es costoso y computacionalmente intensivo.
- Control de acceso: Permite implementar políticas de seguridad y permisos sobre la información a la que el LLM puede acceder.
La calidad de la recuperación es crítica para el éxito de RAG. Un sistema que recupera información irrelevante o incompleta resultará en respuestas deficientes del LLM, incluso si el modelo es potente. Invierta en la calidad de su base de conocimiento y en la estrategia de fragmentación y embedding.
RAG vs. Fine-tuning
Es importante diferenciar RAG del fine-tuning. Aunque ambos buscan mejorar la relevancia de los LLM, lo hacen de maneras distintas:
| Característica | RAG (Retrieval Augmented Generation) | Fine-tuning (Ajuste Fino) |
|---|---|---|
| Modifica el LLM | No, el LLM base permanece sin cambios. | Sí, el LLM se entrena adicionalmente en un conjunto de datos específico, modificando sus pesos internos. |
| Conocimiento | Acceso a conocimiento externo, dinámico y actualizable. | Integra conocimiento en los pesos del modelo, estático hasta el siguiente fine-tuning. |
| Costos | Generalmente menor, enfocado en infraestructura de búsqueda. | Mayor, requiere recursos computacionales para el re-entrenamiento. |
| Aplicación | Ideal para datos que cambian frecuentemente o son muy específicos de la empresa. | Ideal para adaptar el estilo, tono o formato de respuesta del LLM a un dominio particular. |
| Alucinaciones | Reduce significativamente al proporcionar contexto verificable. | Puede reducirse si los datos de fine-tuning son de alta calidad, pero el modelo aún puede alucinar si se le pide información fuera de su dominio de entrenamiento. |
En muchos casos, la combinación de RAG y fine-tuning puede ofrecer los mejores resultados, donde el fine-tuning adapta el modelo al estilo y la terminología de la empresa, y RAG proporciona la información factual actualizada.
Aplicación práctica: Preparación para la implementación de RAG
Antes de la siguiente lección sobre la implementación con Vertex AI Search, comience a identificar las fuentes de datos clave en su área o proyecto que podrían beneficiarse de RAG. Pregúntese:
- ¿Qué documentos internos (manuales, políticas, informes) contienen información valiosa pero dispersa?
- ¿Qué bases de datos o sistemas de gestión de conocimiento podrían integrarse?
- ¿Qué formato tienen estos datos (PDF, DOCX, HTML, CSV, bases de datos)?
- ¿Cuál es el volumen aproximado de estos datos?
- ¿Quién es el propietario o responsable de la calidad de estos datos?
La identificación temprana de estas fuentes es el primer paso para diseñar una arquitectura RAG efectiva y asegurar que el sistema tenga acceso a la información correcta.
No hay comentarios por ahora.
para ser el primero en comentar.