Fundamentos de evaluación de agentes y trayectorias
La evaluación de agentes LangGraph es crítica para asegurar su fiabilidad y eficiencia en producción. Esta lección distingue entre la evaluación de resultados finales y la evaluación de las trayectorias internas, proporcionando el marco para un análisis completo del rendimiento del agente.
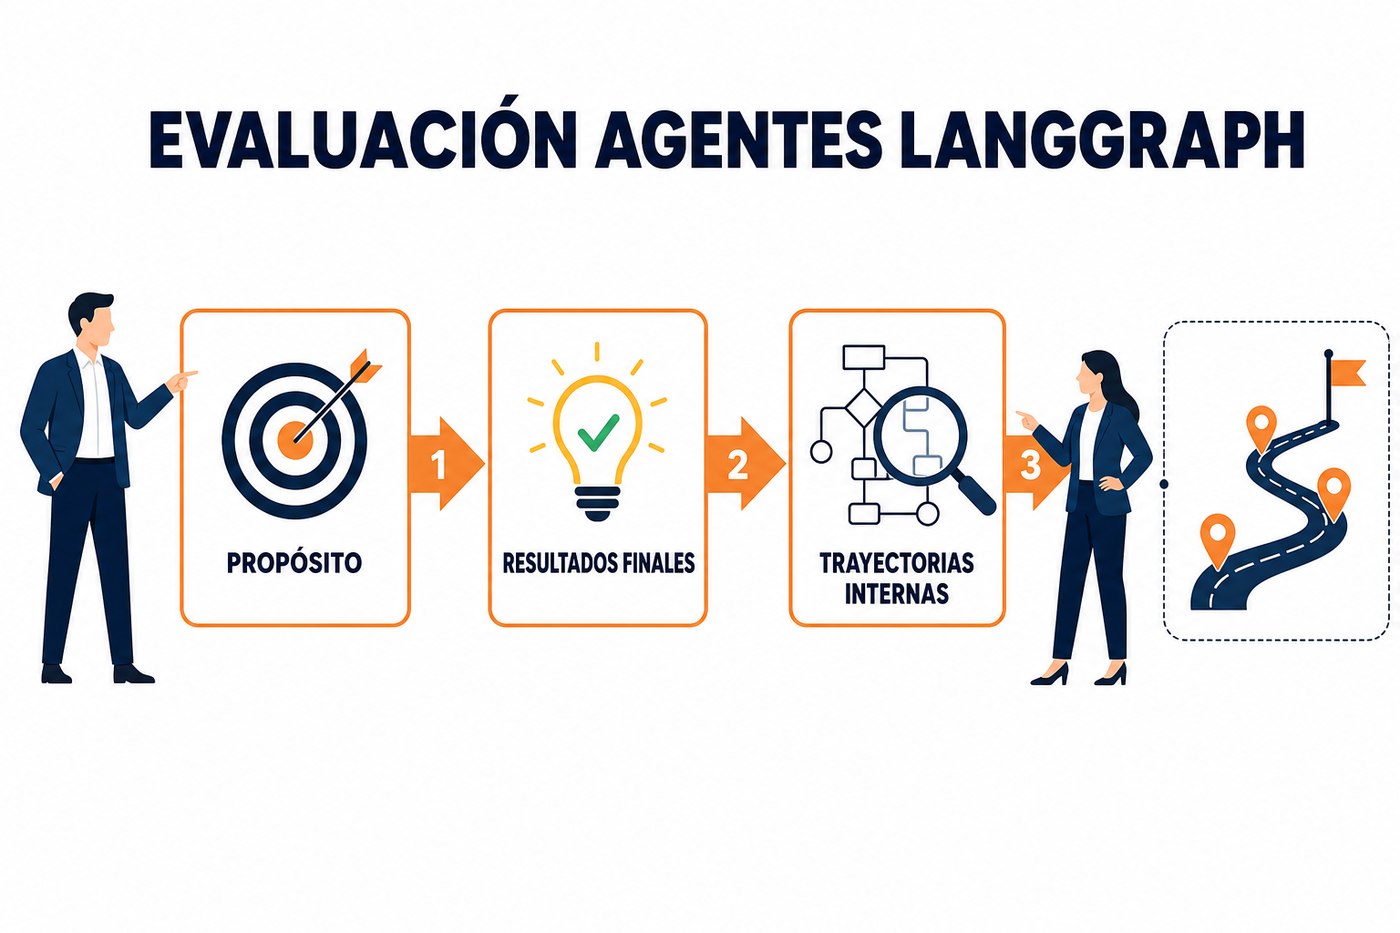
Propósito de la evaluación en producción
Evaluar un agente LangGraph en producción va más allá de verificar si la respuesta final es correcta. Se trata de entender cómo el agente llega a esa respuesta, qué recursos consume y cómo se comporta bajo diversas condiciones. El objetivo es identificar fallos, optimizar el rendimiento y garantizar que el agente cumpla con los requisitos operativos y de negocio. Una evaluación deficiente puede llevar a costos operativos inesperados, respuestas incorrectas o sesgadas, y una experiencia de usuario insatisfactoria.
Evaluación de resultados finales
La evaluación de resultados finales se centra en la calidad de la salida generada por el agente. Es el tipo de evaluación más directo y a menudo el primero que se considera. Los criterios para esta evaluación dependen del caso de uso específico del agente.
- Precisión: ¿La respuesta es correcta y relevante con respecto a la pregunta o tarea? Para agentes de recuperación de información (RAG), esto implica verificar que la información extraída sea la adecuada.
- Coherencia: ¿La respuesta tiene sentido lógico y no contiene contradicciones internas?
- Exhaustividad: ¿La respuesta aborda todos los aspectos de la pregunta o tarea, sin omitir información clave?
- Formato: ¿La respuesta sigue el formato esperado (por ejemplo, JSON, texto plano, resumen)?
- Seguridad: ¿La respuesta evita contenido dañino, sesgado o inapropiado? Esto es crítico para la reputación y cumplimiento.
La evaluación de resultados finales puede ser manual (revisión humana) o automatizada. La automatización requiere métricas bien definidas y, a menudo, el uso de modelos de lenguaje grandes (LLMs) como evaluadores, o la comparación con respuestas de referencia predefinidas en un dataset de prueba.
Evaluación de trayectorias internas
Mientras que la evaluación de resultados finales mide el 'qué', la evaluación de trayectorias internas mide el 'cómo'. Un agente LangGraph es una secuencia de pasos (nodos y aristas). Analizar esta secuencia es crucial para entender el comportamiento del agente, diagnosticar problemas y optimizar el flujo. Esta evaluación es más compleja pero ofrece una visión profunda del razonamiento del agente.
- Lógica del grafo: ¿El agente siguió la secuencia de nodos esperada para una entrada dada? ¿Hubo bucles inesperados o caminos incorrectos?
- Uso de herramientas: ¿El agente seleccionó y utilizó las herramientas correctas en el momento adecuado? ¿Hubo llamadas a herramientas innecesarias o fallidas?
- Consumo de tokens: ¿Cuántos tokens se consumieron en cada paso y en la ejecución total? Un consumo excesivo puede indicar ineficiencias o bucles infinitos.
- Latencia: ¿Cuánto tiempo tomó cada paso y la ejecución completa? Identificar cuellos de botella es vital para la experiencia del usuario.
- Errores y reintentos: ¿Dónde ocurrieron los errores? ¿Los mecanismos de reintento funcionaron correctamente? ¿Hubo fallos en la invocación de LLMs o herramientas externas?
- Decisiones del LLM: ¿Las decisiones tomadas por el LLM en cada nodo (por ejemplo, qué herramienta usar, qué camino seguir) fueron óptimas y justificadas por el contexto?
No te limites a la respuesta final. Un agente puede dar una respuesta correcta por casualidad, o una respuesta correcta con un costo computacional desproporcionado. La evaluación de trayectoria revela la eficiencia y robustez del proceso subyacente.
Herramientas para la observabilidad de trayectorias
La observabilidad es la capacidad de inferir el estado interno de un sistema a partir de sus salidas externas. Para LangGraph, esto implica registrar y visualizar cada paso de la ejecución. Herramientas como LangSmith son fundamentales para esta tarea.
import os
from langsmith import Client

os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_API_KEY"] = "<tu_clave_langsmith>"
os.environ["LANGCHAIN_PROJECT"] = "MiProyectoLangGraph"

# Al ejecutar tu agente, las trazas se enviarán automáticamente a LangSmith.
LangSmith permite ver cada llamada a LLM, cada uso de herramienta y la secuencia completa de estados dentro del grafo. Esto facilita la depuración, la optimización y la comprensión del comportamiento del agente en diferentes escenarios. Sin una herramienta de trazas, la evaluación de trayectorias se vuelve una tarea manual y poco escalable.
Aplicación práctica: qué hacer el lunes
Para empezar a implementar la evaluación de tus agentes LangGraph, enfócate en lo siguiente:
- Define tus métricas de éxito: Clarifica qué significa una "buena respuesta" para tu agente. ¿Es precisión, exhaustividad, formato? Cuantifica estos criterios.
- Habilita el tracing: Integra LangSmith (o una solución similar de tracing) en tu entorno de desarrollo. Asegúrate de que cada ejecución de tu agente genere una traza visible. Esto es el primer paso para la observabilidad de trayectorias.
- Revisa trazas manualmente: Selecciona aleatoriamente 5-10 ejecuciones de tu agente y examina sus trazas en LangSmith. Presta atención a los caminos inesperados, bucles o usos ineficientes de herramientas. Esto te dará una idea inicial de dónde buscar problemas.
- Identifica puntos de fallo: Basándote en tu revisión, anota los nodos o transiciones donde el agente tiende a desviarse o fallar. Estos serán los puntos clave para futuras optimizaciones y pruebas.
There are no comments for now.
to be the first to leave a comment.