Ingeniería de Prompts y Fine-tuning: Optimización de Modelos Base
Esta lección aborda la optimización de modelos base mediante dos técnicas clave: ingeniería de prompts y fine-tuning. Se explicará cuándo y cómo aplicar cada una para adaptar los modelos a tareas específicas, considerando las implicaciones de rendimiento, costo y recursos.
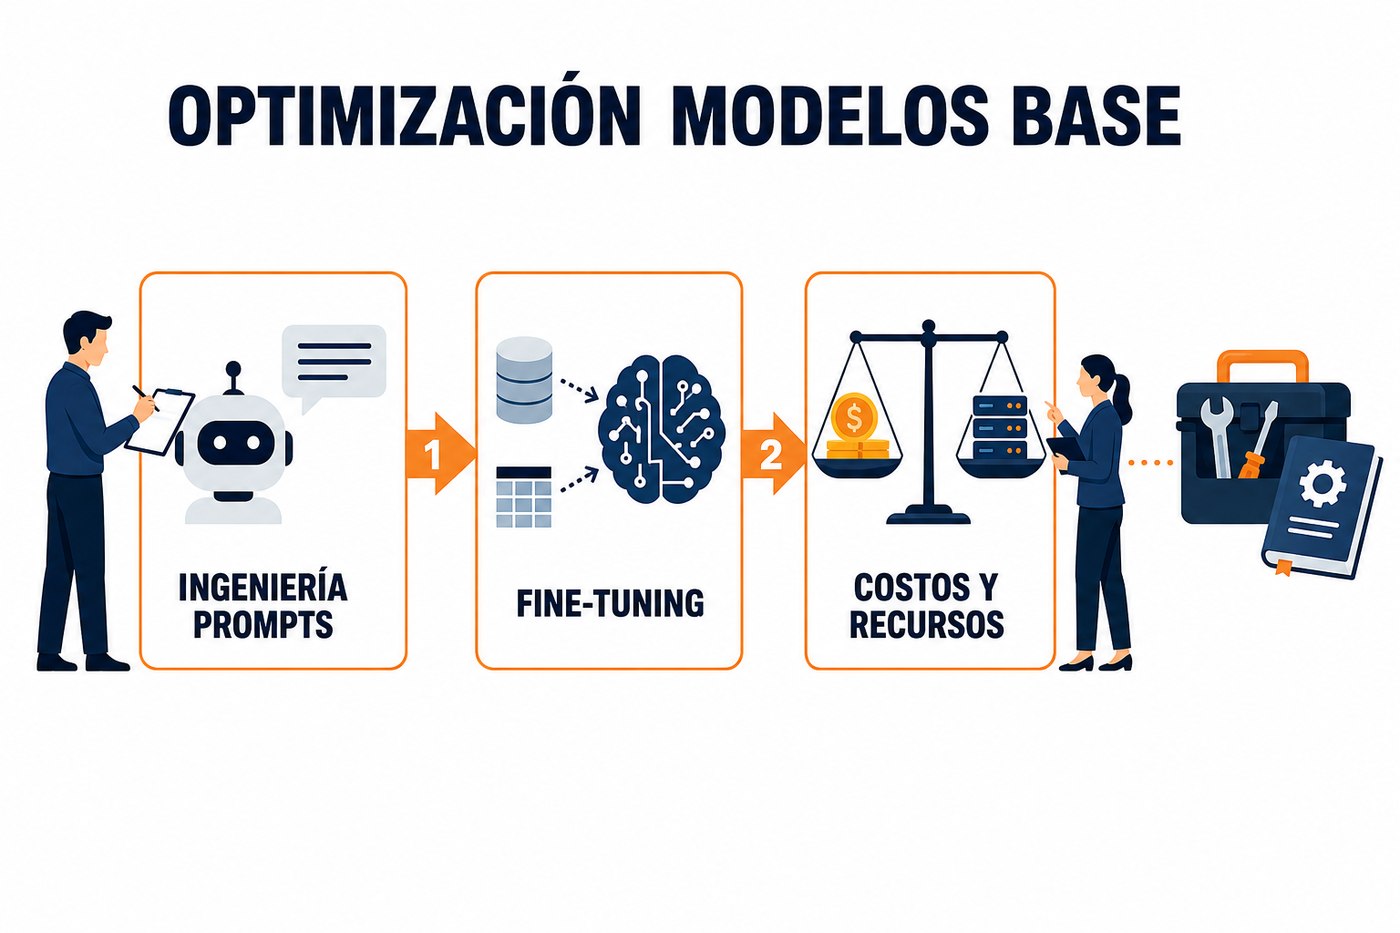
Ingeniería de Prompts: Estrategias para Modelos Base
La ingeniería de prompts es la práctica de diseñar y refinar las entradas (prompts) para obtener respuestas óptimas de un modelo de lenguaje. Es la primera línea de acción para mejorar el rendimiento de un modelo base sin modificar su arquitectura o pesos internos. Un prompt bien diseñado puede cambiar drásticamente la calidad, relevancia y formato de la salida.
Las estrategias se centran en la claridad, especificidad y estructuración del prompt. El objetivo es guiar al modelo de manera inequívoca hacia la tarea deseada.
- Claridad y Especificidad: Indicar explícitamente la tarea, el rol del modelo y el formato de salida. Evitar ambigüedades. Por ejemplo, en lugar de “escribe sobre IA”, usar “actúa como un ingeniero de software y explica el concepto de redes neuronales convolucionales para un público técnico, en 3 párrafos, usando terminología precisa.”
- Ejemplos (Few-Shot Prompting): Proporcionar uno o varios ejemplos de pares entrada-salida. Esto ayuda al modelo a inferir el patrón deseado para la tarea. Es particularmente útil para tareas de clasificación, extracción de información o reescritura con un estilo específico.
- Cadenas de Pensamiento (Chain-of-Thought Prompting): Instruir al modelo para que muestre sus pasos de razonamiento antes de dar la respuesta final. Esto mejora la capacidad del modelo para resolver problemas complejos y reduce errores, especialmente en tareas de lógica o matemáticas. Se logra pidiendo al modelo que "piense paso a paso" o "explique su razonamiento".
- Restricciones y Formato: Definir límites en la longitud, el tono, el estilo o la estructura de la respuesta (e.g., "respuesta en formato JSON", "máximo 100 palabras", "tono formal").
- Contexto Relevante: Incluir toda la información necesaria para que el modelo genere una respuesta precisa, sin asumir conocimiento previo. Esto es crucial para tareas que requieren datos específicos no inherentes al entrenamiento del modelo base.
prompt_ejemplo = """Actúa como un analista de ciberseguridad. Evalúa el siguiente reporte de incidente y resume las 3 vulnerabilidades principales identificadas, proponiendo una acción correctiva para cada una. Formato: JSON con claves 'vulnerabilidad' y 'accion_correctiva'.

Reporte de Incidente:
[Contenido del reporte aquí]"""
Fine-tuning: Adaptación de Modelos con Datos Propios
El fine-tuning es el proceso de entrenar un modelo pre-entrenado en un conjunto de datos más pequeño y específico para una tarea o dominio particular. A diferencia de la ingeniería de prompts, el fine-tuning modifica los pesos internos del modelo, lo que le permite aprender patrones y características específicas de los datos nuevos. Es una técnica más potente cuando la ingeniería de prompts no es suficiente para alcanzar el rendimiento deseado.
El fine-tuning es adecuado para escenarios donde se requiere un alto grado de especialización, un tono de voz muy específico, o la comprensión de terminología única de una empresa o industria. Permite que el modelo se alinee mejor con las expectativas y el contexto operativo de INT.
Cuándo y Cómo Realizar Fine-tuning
El fine-tuning es una inversión de tiempo y recursos. Se justifica cuando:
- La ingeniería de prompts ha alcanzado sus límites y el modelo base aún no cumple con los requisitos de rendimiento.
- Se necesita que el modelo genere respuestas con un estilo, tono o formato muy específico y consistente que es difícil de lograr solo con prompts.
- El modelo debe manejar terminología, jerga o conceptos que son únicos para el dominio de INT y no están bien representados en los datos de entrenamiento del modelo base.
- Se busca reducir la longitud de los prompts al "incrustar" el conocimiento o el estilo deseado directamente en el modelo.
El proceso general de fine-tuning incluye:
- Preparación de Datos: Recopilar y formatear un conjunto de datos de alta calidad que represente la tarea deseada. Esto generalmente implica pares entrada-salida (e.g., pregunta-respuesta, texto-resumen) o ejemplos de texto con el estilo deseado. La cantidad de datos necesarios varía, pero cientos o miles de ejemplos son un buen punto de partida. La calidad es más importante que la cantidad bruta.
- Selección del Modelo Base: Elegir un modelo pre-entrenado adecuado para la tarea. Azure AI Foundry ofrece acceso a varios modelos que pueden ser fine-tuned.
- Configuración del Fine-tuning: Definir hiperparámetros como la tasa de aprendizaje, el número de épocas y el tamaño del lote. Azure AI Foundry simplifica este proceso con herramientas y APIs.
- Entrenamiento: Ejecutar el proceso de fine-tuning en la infraestructura de Azure. Esto consume recursos de cómputo (GPUs).
- Evaluación: Medir el rendimiento del modelo fine-tuned en un conjunto de datos de validación independiente para asegurar que ha aprendido la tarea específica y no ha sobreajustado los datos de entrenamiento.
Antes de considerar el fine-tuning, asegúrese de haber explorado exhaustivamente las capacidades de la ingeniería de prompts. El fine-tuning es más costoso y complejo; solo debe emplearse cuando las técnicas de prompting no logran el resultado requerido.
Implicaciones de Costos y Recursos
El fine-tuning tiene implicaciones significativas en costos y recursos en comparación con la ingeniería de prompts:
- Costo de Cómputo: El entrenamiento requiere GPUs, lo que se traduce en costos de Azure AI Studio o Azure Machine Learning. La duración del entrenamiento y el tipo de GPU impactan directamente en el costo.
- Costo de Almacenamiento: Los conjuntos de datos de fine-tuning deben almacenarse, generando costos de almacenamiento.
- Tiempo de Desarrollo: Preparar datos, configurar y ejecutar el fine-tuning, y evaluar el modelo consume tiempo de ingenieros.
- Mantenimiento: Los modelos fine-tuned deben ser monitoreados y ocasionalmente re-entrenados con datos actualizados para mantener su relevancia y rendimiento.
- Costo de Inferencia: Si bien un modelo fine-tuned puede requerir prompts más cortos, el costo de inferencia por token puede ser similar o ligeramente superior al del modelo base, dependiendo de la plataforma y el modelo específico.
| Característica | Ingeniería de Prompts | Fine-tuning |
|---|---|---|
| Complejidad | Baja a Media | Media a Alta |
| Costo Inicial | Bajo (tiempo de diseño) | Alto (cómputo, datos, tiempo) |
| Costo de Inferencia | Depende de la longitud del prompt | Similar al modelo base, prompts más cortos |
| Adaptación | Superficial, guiada por prompt | Profunda, modifica pesos del modelo |
| Datos Requeridos | Ninguno adicional (solo el prompt) | Conjunto de datos de entrenamiento específico |
| Flexibilidad | Alta, cambio rápido de estrategia | Menor, requiere re-entrenamiento |
| Casos de Uso | Tareas generales, experimentación rápida | Especialización de dominio, tono de voz, reducción de prompt |
Aplicación Práctica: Qué Hacer el Lunes
Para aplicar los conceptos de esta lección:
- Experimenta con Prompts: Selecciona un modelo base en Azure AI Foundry y una tarea común en INT (e.g., resumir documentos técnicos, generar descripciones de soluciones). Dedica tiempo a diseñar prompts utilizando las estrategias de claridad, ejemplos y cadenas de pensamiento. Registra los resultados para entender qué funciona mejor.
- Identifica Casos de Fine-tuning: Si encuentras tareas donde la ingeniería de prompts es insuficiente o los prompts se vuelven excesivamente largos y complejos, documenta estos casos como candidatos potenciales para fine-tuning. Evalúa si tienes acceso a los datos necesarios para entrenar un modelo.
- Calcula el ROI: Para los casos identificados para fine-tuning, realiza una estimación preliminar de los costos de cómputo y el esfuerzo de preparación de datos versus el beneficio esperado en rendimiento o eficiencia operativa. Considera si el costo de mantener prompts largos y complejos supera el costo de un fine-tuning inicial.
There are no comments for now.
to be the first to leave a comment.