Introducción a la Inferencia de Modelos de IA
La inferencia de modelos de IA es la fase operativa donde un modelo entrenado genera predicciones o decisiones a partir de nuevos datos. Es el punto donde la inversión en desarrollo de IA se traduce en valor práctico, impactando directamente la funcionalidad y el rendimiento de sistemas productivos. Comprender sus fundamentos es crucial para el despliegue eficiente y escalable.
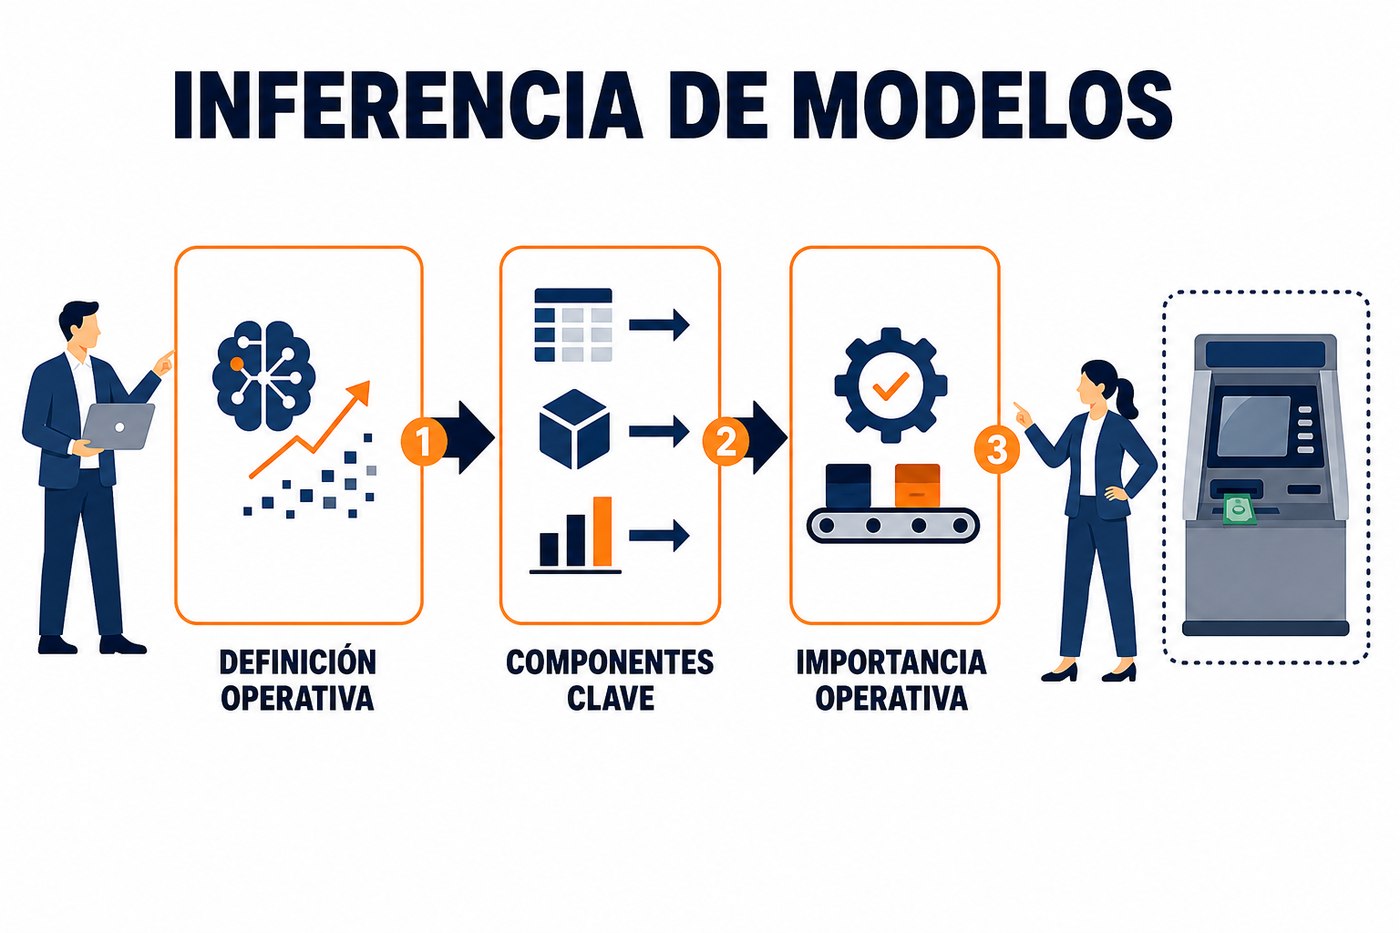
Definición Operativa de Inferencia
La inferencia es el proceso de ejecutar un modelo de inteligencia artificial ya entrenado sobre datos nuevos y no vistos previamente para obtener una salida específica. Esta salida puede ser una clasificación, una predicción numérica, la generación de texto o imágenes, o cualquier otra tarea para la que el modelo fue diseñado. A diferencia del entrenamiento, que es intensivo en cómputo y datos históricos, la inferencia se enfoca en la velocidad y eficiencia para procesar datos en tiempo real o casi real, a menudo con recursos computacionales limitados por la operación.
En un contexto productivo, la inferencia es el motor que impulsa las aplicaciones de IA. Por ejemplo, un sistema de detección de fraude realiza inferencia para clasificar una transacción como legítima o fraudulenta. Un chatbot realiza inferencia para entender la intención de un usuario y generar una respuesta coherente. La calidad y velocidad de esta inferencia determinan directamente la experiencia del usuario y la efectividad del sistema.
Componentes Clave del Proceso de Inferencia
Para que la inferencia sea efectiva, se requiere la interacción de varios componentes:
- Modelo Entrenado: El algoritmo de IA que ha aprendido patrones a partir de un conjunto de datos. Este modelo se serializa (guarda en un formato específico) para su despliegue.
- Datos de Entrada (Input): La información nueva que se alimenta al modelo para obtener una predicción. Estos datos deben tener el mismo formato y preprocesamiento que los datos usados durante el entrenamiento.
- Motor de Inferencia (Runtime): El software que carga el modelo entrenado y ejecuta las operaciones matemáticas necesarias para generar la salida. Ejemplos incluyen ONNX Runtime, TensorFlow Serving, PyTorch JIT, y soluciones específicas como NVIDIA TensorRT.
- Hardware de Inferencia: El equipo físico donde se ejecuta el motor de inferencia. Esto puede ser una CPU, una GPU, una TPU, o un ASIC especializado. La elección del hardware impacta directamente la latencia y el throughput.
- Salida (Output): La predicción, clasificación o generación resultante del modelo, que luego es utilizada por la aplicación cliente.
Importancia Operativa en Sistemas Productivos
La inferencia es el punto donde la IA genera valor. Su importancia operativa radica en varios aspectos:
- Toma de Decisiones en Tiempo Real: Muchos sistemas requieren respuestas inmediatas. Un sistema de recomendación, por ejemplo, debe inferir preferencias en milisegundos para ser relevante.
- Escalabilidad: Los sistemas productivos deben manejar volúmenes variables de solicitudes. La infraestructura de inferencia debe ser capaz de escalar para satisfacer la demanda sin comprometer el rendimiento.
- Eficiencia de Recursos: Ejecutar inferencia de manera eficiente reduce los costos operativos. Optimizar el uso de CPU, GPU y memoria es fundamental, especialmente en despliegues a gran escala.
- Fiabilidad y Disponibilidad: Los sistemas de inferencia deben ser robustos y estar disponibles continuamente. Fallas en la inferencia pueden detener procesos críticos o afectar la experiencia del usuario.
- Mantenimiento y Actualización: La capacidad de actualizar modelos sin interrupciones significativas es vital para mejorar el rendimiento y adaptarse a nuevos datos.
No confundir la precisión del modelo con la eficiencia de inferencia. Un modelo muy preciso pero lento o costoso de inferir en producción puede ser menos útil que uno ligeramente menos preciso pero con una inferencia rápida y económica. El balance es clave.
Diferencias Clave: Entrenamiento vs. Inferencia
Aunque ambos procesos son fundamentales en el ciclo de vida de un modelo de IA, presentan diferencias significativas en sus requisitos y objetivos:
| Característica | Entrenamiento | Inferencia |
|---|---|---|
| Objetivo Principal | Aprender patrones a partir de datos | Aplicar patrones aprendidos a nuevos datos |
| Intensidad de Cómputo | Muy alta (cientos o miles de horas de GPU) | Moderada a alta (milisegundos por solicitud) |
| Volumen de Datos | Grandes conjuntos de datos históricos | Pequeños lotes o datos individuales en tiempo real |
| Recursos Típicos | Múltiples GPU de alto rendimiento, clústeres | CPU, GPU (una o pocas), edge devices |
| Latencia | No crítica (puede tomar horas/días) | Crítica (milisegundos a segundos) |
| Frecuencia | Periódico (semanal, mensual, trimestral) | Continua (miles a millones de solicitudes por día) |
Comprender estas diferencias es crucial para diseñar arquitecturas de IA que sean eficientes tanto en el desarrollo como en la operación.
Aplicación Práctica: Preparando la Infraestructura
Para el lunes, identifique los modelos de IA actualmente en uso o planeados para despliegue en su área. Para cada uno, responda a las siguientes preguntas:
- ¿Cuál es el objetivo de negocio de la inferencia de este modelo?
- ¿Cuál es la latencia máxima aceptable para una solicitud de inferencia?
- ¿Cuál es el volumen esperado de solicitudes por segundo (QPS) en picos y en promedio?
- ¿Qué tipo de datos de entrada recibe el modelo y cómo se preprocesan?
- ¿Qué hardware se está utilizando o se planea utilizar para la inferencia?
Esta información será la base para evaluar los desafíos de escalado y optimización que abordaremos en las próximas lecciones. Un entendimiento claro de estos puntos permite tomar decisiones informadas sobre la infraestructura y las herramientas de despliegue.
There are no comments for now.
to be the first to leave a comment.