Gestión de límites de tokens y costos en Codex
La gestión eficiente de tokens es crucial para optimizar el uso de OpenAI Codex. Esta lección aborda cómo los límites de tokens y los costos impactan el desarrollo, y presenta estrategias para minimizar el consumo sin sacrificar la calidad de las respuestas.
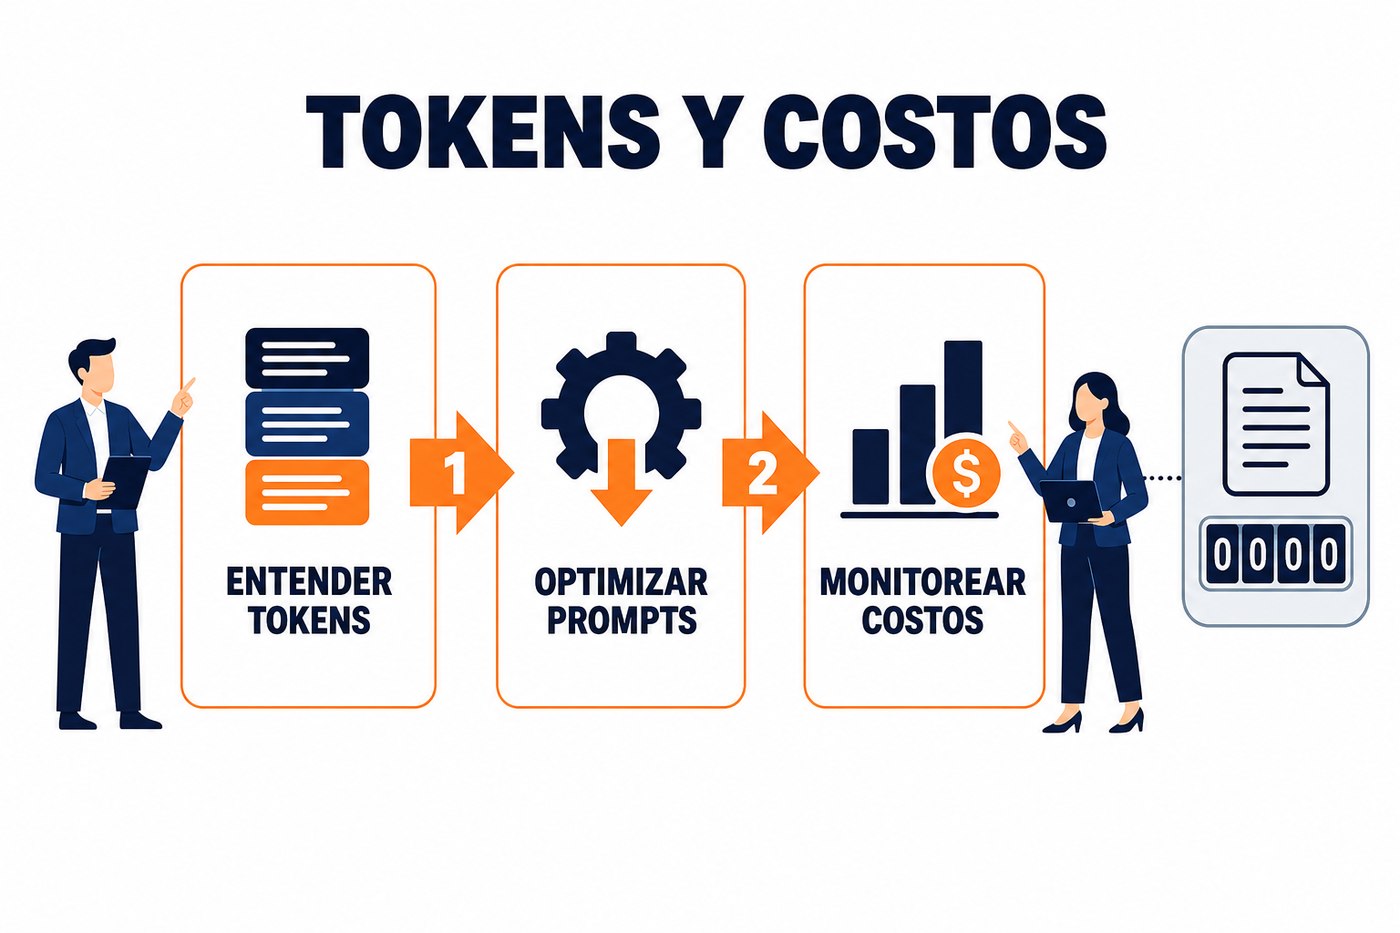
El modelo de tokens y su impacto
Codex opera con un modelo de tokens, donde cada palabra o fragmento de palabra se convierte en uno o más tokens. La longitud de los prompts de entrada y las respuestas generadas se mide en tokens. OpenAI establece límites máximos de tokens por solicitud, que varían según el modelo específico utilizado. Superar este límite resulta en un error de la API y una solicitud fallida.
Además del límite técnico, cada token tiene un costo asociado. Aunque el costo por token es bajo, el uso intensivo en proyectos grandes o con prompts extensos puede generar gastos significativos. Comprender este modelo es el primer paso para una gestión efectiva de recursos.
Estrategias para la optimización de prompts
Para mantener los prompts dentro de los límites y reducir costos, se pueden aplicar varias estrategias:
- Fragmentación de tareas: En lugar de pedir a Codex que realice una tarea compleja en un solo prompt, divídala en subtareas más pequeñas y secuenciales. Cada subtarea tendrá un prompt y una respuesta más corta, lo que reduce el consumo de tokens por interacción.
- Minimización del contexto: Incluya solo la información estrictamente necesaria para que Codex entienda la solicitud y genere una respuesta útil. Evite descripciones redundantes, ejemplos excesivos o bloques de código no relevantes para la tarea actual.
- Refinamiento de instrucciones: Sea conciso y directo en sus instrucciones. Un lenguaje claro y específico reduce la ambigüedad, lo que a menudo permite a Codex generar respuestas precisas con menos tokens. Evite frases vagas o peticiones abiertas.
- Uso de resúmenes: Si necesita proporcionar un contexto extenso (ej. un archivo completo o un log de errores), considere resumir la información clave antes de pasarla a Codex. Puede incluso usar otro modelo de lenguaje para generar el resumen.
La optimización de tokens no debe comprometer la calidad de la respuesta. Es preferible un prompt ligeramente más largo que produzca el resultado correcto a uno muy corto que requiera múltiples iteraciones o correcciones manuales.
Monitoreo y cálculo de costos
OpenAI proporciona herramientas y APIs para monitorear el uso de tokens. Es fundamental integrar estas funcionalidades en sus flujos de trabajo de desarrollo para tener visibilidad sobre el consumo. Esto permite identificar patrones de uso ineficientes y ajustar las estrategias de prompts.
El costo se calcula por tokens de entrada y tokens de salida. Un prompt muy largo con una respuesta corta puede ser más costoso que un prompt corto con una respuesta larga, dependiendo de las tarifas específicas del modelo. Consulte la documentación de precios de OpenAI para los modelos de Codex para obtener las tarifas actualizadas.
# Ejemplo conceptual de cómo se podría estimar el uso de tokens
# Esto no es una API real de OpenAI para contar tokens, es ilustrativo

def estimate_tokens(text):
    # Una aproximación muy simplificada: 1 palabra ~ 1.3 tokens en inglés
    # En español, puede variar. La API de OpenAI tiene un contador preciso.
    words = text.split()
    return int(len(words) * 1.3)

prompt = "Genera una función Python que invierta una cadena."
response = """def reverse_string(s):
    return s[::-1]"""

input_tokens = estimate_tokens(prompt)
output_tokens = estimate_tokens(response)

print(f"Tokens de entrada estimados: {input_tokens}")
print(f"Tokens de salida estimados: {output_tokens}")
# Costo total = (input_tokens * precio_entrada) + (output_tokens * precio_salida)
Consideraciones para agentes autónomos
Cuando se desarrollan agentes de código que interactúan repetidamente con Codex, la gestión de tokens se vuelve aún más crítica. Un agente puede consumir rápidamente miles de tokens en una sesión si no se le restringe. Implemente mecanismos para limitar la profundidad de la recursión, el número de intentos o la longitud del contexto que el agente puede mantener.
- Ventanas de contexto deslizantes: Mantenga solo el historial de conversación o código más reciente que sea relevante para la tarea actual del agente. Descarte información antigua o irrelevante.
- Caché de respuestas: Si un agente realiza consultas repetitivas que pueden tener respuestas idénticas, implemente un sistema de caché para evitar llamar a la API de Codex innecesariamente.
- Lógica de decisión: Programe al agente para que tome decisiones inteligentes sobre cuándo y cómo interactuar con Codex, evitando llamadas redundantes o prompts excesivamente largos.
Aplicación práctica: qué hacer el lunes
El lunes, al trabajar con Codex, implemente lo siguiente:
- Evalúe la longitud de sus prompts: Antes de enviar un prompt, estímesu longitud en tokens. Si es excesivamente largo, identifique y elimine la información no esencial. Utilice herramientas de conteo de tokens si están disponibles (algunas librerías de OpenAI ofrecen esta funcionalidad).
- Divida tareas complejas: Si su prompt busca generar una función completa con múltiples dependencias o lógica compleja, fragméntelo. Primero, pida la estructura básica, luego las dependencias, y finalmente la implementación de cada parte.
- Monitoree el uso: Si su proyecto tiene acceso a las métricas de uso de OpenAI, revíselas al menos semanalmente para identificar patrones de consumo y posibles áreas de optimización. Configure alertas si los costos superan un umbral predefinido.
There are no comments for now.
to be the first to leave a comment.