Gestión del contexto del repositorio para Codex
Para que Codex genere código útil, necesita entender el entorno donde operará. Esta lección explica cómo proporcionar el contexto del repositorio, incluyendo archivos existentes, esquemas de bases de datos y dependencias, para evitar código aislado o redundante y mejorar la precisión de las sugerencias.
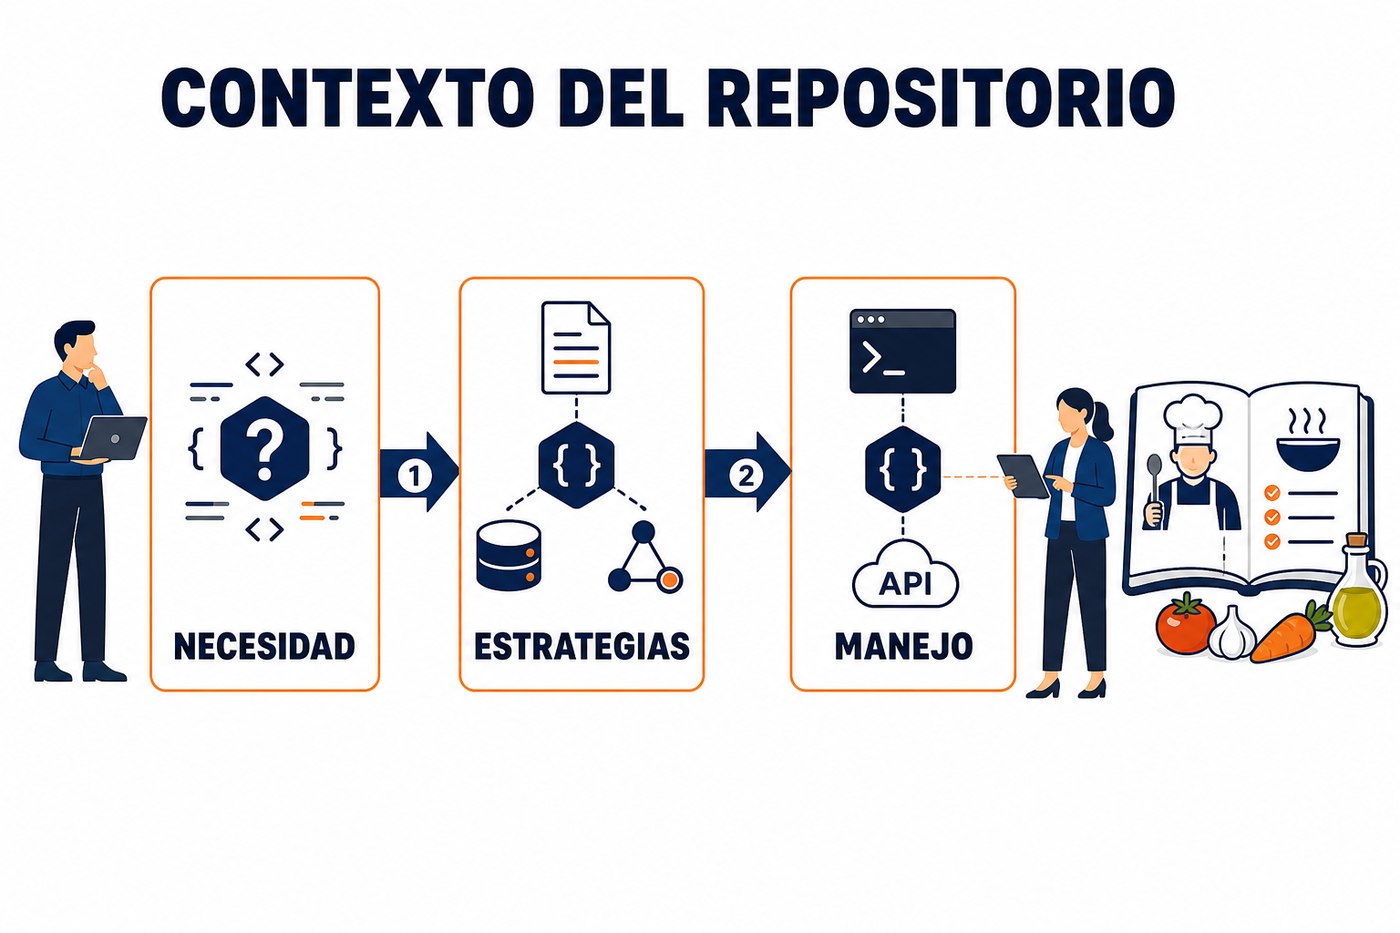
La necesidad del contexto: por qué Codex no es un oráculo
Codex es un modelo de lenguaje entrenado en una vasta cantidad de código, pero no tiene conocimiento inherente de su proyecto específico. Si se le pide generar una función sin más información, producirá código sintácticamente correcto, pero que probablemente no se integre con su arquitectura, convenciones de nombres o dependencias existentes. Es como pedirle a un nuevo desarrollador que escriba una función sin darle acceso al repositorio ni explicarle el alcance del proyecto.
El contexto es la información que le damos a Codex sobre el estado actual del proyecto. Esto incluye la estructura de directorios, el contenido de archivos relevantes, las definiciones de clases o funciones ya implementadas, los esquemas de bases de datos, las configuraciones de API y las dependencias del proyecto. Sin este contexto, el código generado será genérico y requerirá una refactorización significativa para ser útil.
Estrategias para proporcionar contexto relevante
La clave es ser selectivo. Incluir todo el repositorio es ineficiente y puede diluir la relevancia de la información crítica. Las estrategias se centran en identificar y presentar solo lo esencial para la tarea actual.
- Inclusión de archivos adyacentes: Si está trabajando en un archivo `mi_modulo.py` y necesita una función que interactúe con `modelo_datos.py` y `utilidades.py`, incluya el contenido de estos últimos en el prompt. Esto permite a Codex ver las definiciones de clases, funciones y variables que ya existen.
- Esquemas de bases de datos: Para tareas que implican interacción con bases de datos (SQLAlchemy, Django ORM, etc.), proporcione el esquema de la tabla o el modelo de datos relevante. Un `CREATE TABLE` o la definición de un modelo ORM es mucho más útil que una descripción en lenguaje natural.
- Definiciones de API y contratos de servicio: Si la tarea implica consumir o exponer una API, incluya la especificación OpenAPI/Swagger, o al menos los esquemas de request/response y los endpoints relevantes.
- Archivos de configuración y dependencias: Para entender el entorno de ejecución o las librerías disponibles, puede ser útil incluir `requirements.txt`, `package.json` o fragmentos de `pyproject.toml`.
Priorice el contexto que define la interfaz y la estructura sobre el contexto de implementación interna que no es directamente relevante para la tarea. Demasiado contexto irrelevante puede confundir a Codex y aumentar el tiempo de procesamiento.
Manejo del contexto en la CLI y API
Tanto en la CLI como en la API, el contexto se proporciona concatenando el contenido de los archivos relevantes al prompt principal. Es crucial mantener la sintaxis del lenguaje de programación. Por ejemplo, si está pidiendo código Python, el contexto debe ser código Python válido.
cat modelo_datos.py utilidades.py mi_modulo.py | openai api completions.create -m codex-davinci-002 -p """$(cat -)
# Escribe una función que use las clases definidas arriba para..."""
En este ejemplo, `cat` concatena el contenido de los archivos y lo pasa como parte del prompt a la API. Observe el uso de `$(cat -)` para inyectar el contenido concatenado antes de la instrucción específica. La longitud total del prompt (contexto + instrucción) está limitada por el tamaño de la ventana de contexto del modelo.
Consideraciones sobre la ventana de contexto
Los modelos de lenguaje tienen una 'ventana de contexto' finita, que es la cantidad máxima de tokens (palabras o subpalabras) que pueden procesar en una sola solicitud. Exceder este límite resultará en un error o en el truncamiento del prompt.
- Monitoreo de tokens: Familiarícese con la forma de calcular los tokens para su modelo específico. Herramientas y librerías de OpenAI permiten estimar el uso de tokens antes de enviar la solicitud.
- Truncamiento inteligente: Si el contexto es demasiado grande, considere truncar archivos menos relevantes o resumir secciones. Por ejemplo, en lugar de un archivo de configuración completo, solo incluya las variables o secciones que impactan la tarea actual.
- Descomposición de tareas: Para tareas complejas que requieren mucho contexto, divida la solicitud en pasos más pequeños, cada uno con su propio contexto enfocado. Por ejemplo, primero pida la definición de una interfaz, luego la implementación de un método, y así sucesivamente.
Evitando la redundancia y el código aislado
El objetivo de proporcionar contexto es que Codex genere código que se integre sin problemas con el proyecto existente. Esto significa evitar:
- Redefiniciones: Si una clase o función ya está definida en el contexto, Codex no debería intentar redefinirla, sino usarla.
- Importaciones duplicadas o incorrectas: Con el contexto adecuado, Codex puede inferir qué módulos necesitan ser importados y cómo hacerlo correctamente.
- Patrones de diseño inconsistentes: Si el contexto muestra un patrón de diseño particular (e.g., inyección de dependencias, uso de un ORM específico), Codex tenderá a seguir ese patrón en el código generado.
La calidad del código generado es directamente proporcional a la calidad y relevancia del contexto proporcionado. Un buen contexto es una inversión que reduce el tiempo de revisión y refactorización.
Aplicación práctica: Preparando el contexto para una nueva función
El lunes, antes de pedir a Codex que escriba una nueva función o refactorice un bloque de código, siga estos pasos:
- Identifique los archivos clave: Determine qué archivos de su repositorio contienen clases, funciones, modelos de datos o configuraciones que la nueva tarea necesitará conocer. Esto podría incluir archivos de modelos, utilidades, interfaces de servicio o configuraciones.
- Extraiga el contenido relevante: Copie el contenido de esos archivos. No incluya comentarios extensos o código muerto que no aporte al entendimiento de la estructura o las interfaces.
- Combine el contexto con su prompt: Concatene el contenido extraído al inicio de su prompt, seguido de la instrucción clara para Codex. Asegúrese de que el contexto esté bien delimitado del prompt principal (por ejemplo, con un comentario o un separador claro si el modelo lo permite).
- Revise el tamaño del prompt: Antes de enviar, estime el número de tokens. Si se acerca al límite, priorice la información más crítica y elimine lo menos relevante. La concisión es clave.
Un prompt bien contextualizado es el primer paso para obtener código funcional y bien integrado, reduciendo la necesidad de intervenciones manuales posteriores.
There are no comments for now.
to be the first to leave a comment.