Árboles de decisión, Random Forest y Boosting
Los árboles de decisión son modelos interpretables que dividen los datos con preguntas sucesivas (if/else).
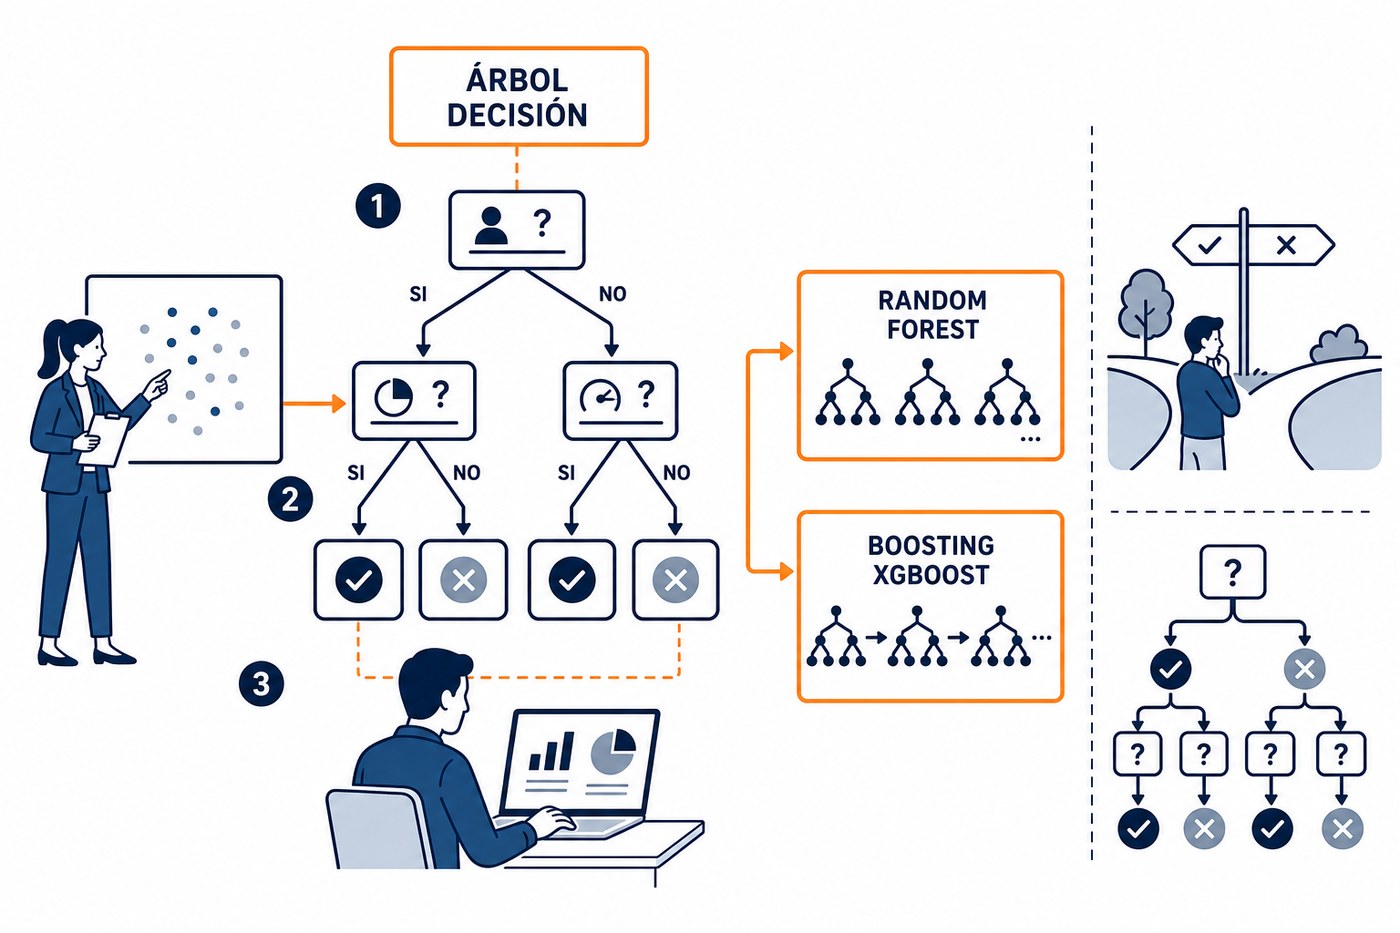
Un árbol decide solo; un bosque aleatorio combina muchos.
Árbol de decisión
- Cada nodo plantea una condición (¿ingreso > 30k?).
- Las hojas son el resultado (aprobar / rechazar).
- Ventaja: fáciles de explicar. Riesgo: sobreajuste.
Random Forest (ensamble)
Combina muchos árboles entrenados con subconjuntos aleatorios de datos y de variables, y vota (clasificación) o promedia (regresión). Reduce la varianza y el sobreajuste.
Boosting (XGBoost, LightGBM)
Entrena árboles en secuencia, donde cada nuevo árbol corrige los errores del anterior. Suele ser el mejor en datos tabulares.
ANALOGÍA
un árbol = un solo experto. Un bosque aleatorio = cientos de expertos que votan. Boosting = expertos que se van especializando en lo que el anterior falló.
Calificación
No hay comentarios por ahora.
para ser el primero en comentar.