Estrategias de Continuidad Operativa (HA/DR)
La continuidad operativa de OpenClaw es crítica para procesos automatizados. Esta lección aborda el diseño e implementación de estrategias de alta disponibilidad (HA) y recuperación ante desastres (DR) para asegurar la resiliencia de la plataforma. Se cubrirán enfoques para minimizar el tiempo de inactividad y la pérdida de datos.
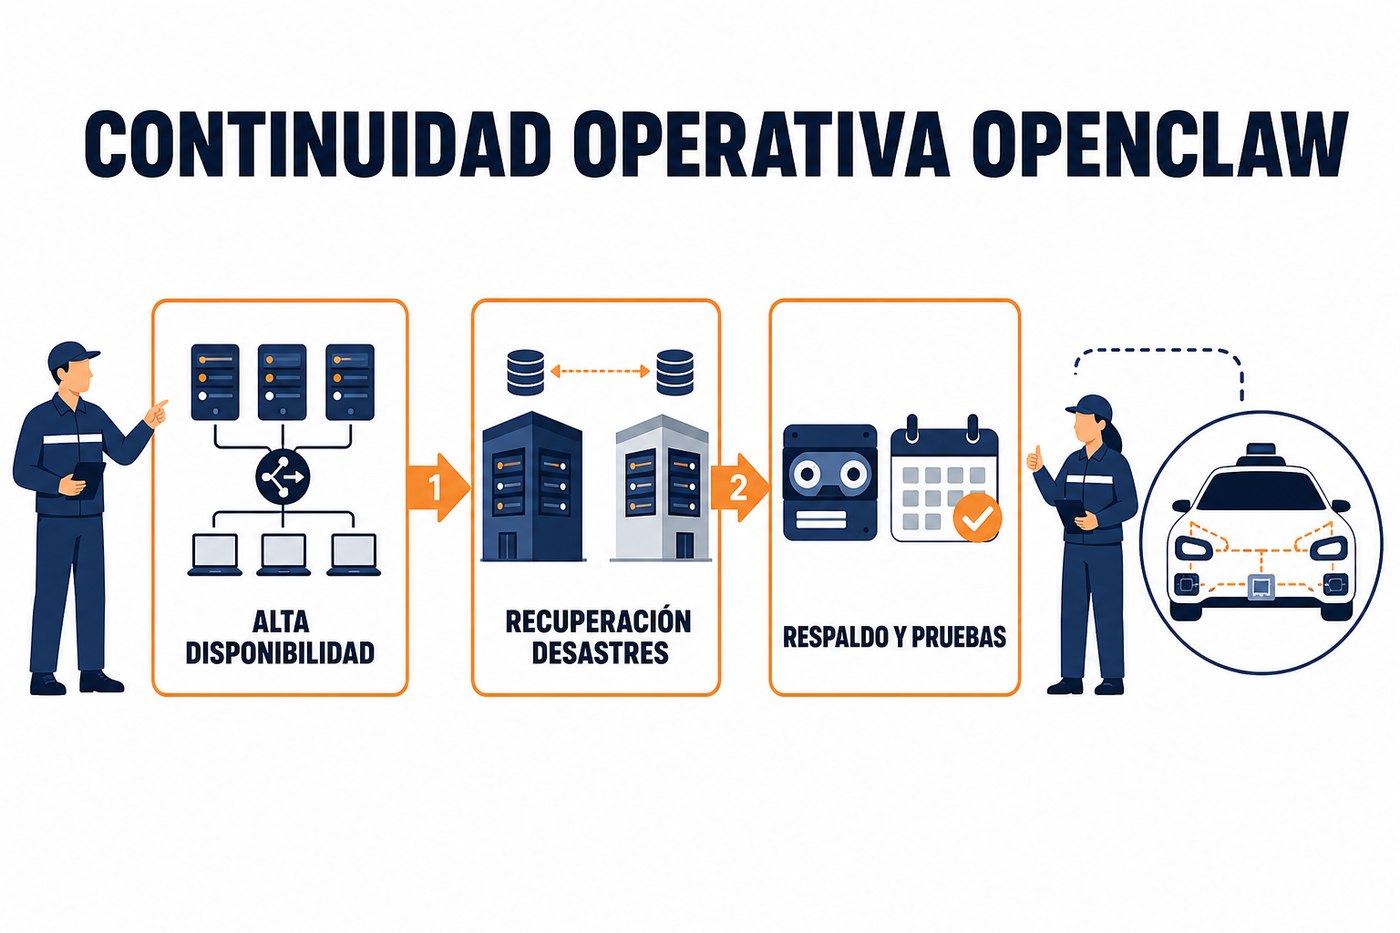
Principios de Alta Disponibilidad (HA) para OpenClaw
La alta disponibilidad busca mantener OpenClaw operativo ante fallas de componentes individuales. Esto se logra mediante la redundancia y la distribución de la carga. Para OpenClaw, los componentes clave a considerar son las instancias de ejecución (nodos), la base de datos de configuración y estado, y el almacenamiento de artefactos y logs.
La arquitectura multiagente de OpenClaw facilita la HA. Múltiples nodos de ejecución pueden operar de forma concurrente, procesando tareas y compartiendo la carga. Si un nodo falla, las tareas pueden ser reasignadas a otros nodos operativos, dependiendo de la configuración del orquestador y la persistencia de la cola de tareas.
- Redundancia de Nodos: Desplegar múltiples instancias de OpenClaw en diferentes servidores o máquinas virtuales. Utilizar un balanceador de carga para distribuir las solicitudes y un mecanismo de failover para redirigir el tráfico en caso de falla de un nodo.
- Base de Datos Distribuida o Replicada: La base de datos que almacena la configuración de OpenClaw, el estado de las tareas y los metadatos debe ser altamente disponible. Implementar replicación síncrona o asíncrona (según la tolerancia a la pérdida de datos) o utilizar servicios de bases de datos gestionados con HA integrada.
- Almacenamiento Compartido y Replicado: Los directorios de trabajo, artefactos generados y logs deben residir en un almacenamiento compartido (ej. NFS, S3 compatible) que esté replicado o sea intrínsecamente redundante.
Diseño de Recuperación ante Desastres (DR) para OpenClaw
La recuperación ante desastres se enfoca en restaurar la operación de OpenClaw después de un evento catastrófico que afecte una región completa o un centro de datos. Requiere una estrategia que involucre sitios geográficamente separados.
Los objetivos clave en DR son el RTO (Recovery Time Objective), que es el tiempo máximo aceptable para restaurar el servicio, y el RPO (Recovery Point Objective), que es la cantidad máxima de datos que se puede perder. Estos objetivos dictarán la complejidad y el costo de la solución de DR.
- Sitio de Recuperación: Establecer un sitio de DR en una ubicación geográfica distinta. Este sitio puede ser un hot standby (activo-activo o activo-pasivo con replicación continua), un warm standby (sitio con infraestructura lista para arrancar y datos replicados periódicamente) o un cold standby (infraestructura mínima, restauración desde respaldos).
- Replicación de Datos: Implementar replicación de la base de datos y del almacenamiento de artefactos entre el sitio primario y el de DR. La frecuencia de la replicación debe alinearse con el RPO. Para RPO cercanos a cero, se requiere replicación síncrona, lo que puede introducir latencia.
- Automatización del Failover: Desarrollar y probar procedimientos automatizados para el failover al sitio de DR. Esto incluye la reconfiguración de DNS, la activación de instancias de OpenClaw en el sitio secundario y la reorientación de las fuentes de datos.
El RTO y RPO no son aspiraciones, son compromisos operativos. Deben definirse con el negocio y ser la base para la selección de tecnologías y el diseño de la arquitectura de continuidad. Un RPO de cero es costoso y no siempre necesario.
Respaldo y Restauración de la Configuración de OpenClaw
Independientemente de las estrategias de HA/DR, los respaldos regulares de la configuración de OpenClaw son esenciales. Esto incluye la base de datos de OpenClaw y cualquier archivo de configuración externo o scripts personalizados.
- Base de Datos: Realizar respaldos lógicos (ej.
pg_dumppara PostgreSQL) y/o físicos (snapshots de volumen) de la base de datos de OpenClaw. Almacenar estos respaldos en una ubicación segura y replicada, preferiblemente fuera del sitio primario. - Archivos de Configuración: Versionar y respaldar todos los archivos de configuración de OpenClaw (ej.
openclaw.conf, configuraciones de plugins, credenciales) utilizando un sistema de control de versiones (ej. Git) y un sistema de respaldo de archivos. - Scripts y Automatizaciones: Cualquier script o automatización personalizada que interactúe con OpenClaw debe ser versionado y respaldado. Esto incluye scripts de monitoreo, integraciones o tareas específicas.
Los procedimientos de restauración deben ser documentados y probados periódicamente. Un respaldo sin un procedimiento de restauración probado es un respaldo inútil.
Pruebas de Continuidad Operativa
Las estrategias de HA y DR no son estáticas; requieren pruebas periódicas para asegurar su efectividad. Las pruebas validan que los procedimientos de failover y restauración funcionan como se espera y que los RTO/RPO definidos pueden ser alcanzados.
- Pruebas de Failover de HA: Simular la falla de un nodo de OpenClaw o de un componente de su base de datos para verificar que el sistema conmuta automáticamente a los componentes redundantes sin interrupción o con una interrupción mínima.
- Simulacros de DR: Realizar simulacros completos de recuperación ante desastres, donde se simula la pérdida del sitio primario y se activa el sitio de DR. Esto debe incluir la restauración de datos, el arranque de OpenClaw y la validación de la funcionalidad.
- Validación de Datos: Después de cualquier failover o restauración, es crucial validar la integridad y consistencia de los datos en OpenClaw. Esto puede implicar la ejecución de tareas de prueba o la comparación de estados antes y después del evento.
La frecuencia de las pruebas debe ser proporcional a la criticidad de OpenClaw y a la frecuencia de cambios en la infraestructura o en la configuración de la plataforma.
Aplicación Práctica: Diseño Inicial de HA/DR para OpenClaw
Para el lunes, identifique los componentes críticos de su implementación de OpenClaw y comience a diseñar un plan de continuidad operativa inicial. No es necesario implementar todo de inmediato, pero sí tener un plan claro.
- Evalúe la Criticidad: Determine qué tan crítico es OpenClaw para las operaciones de su organización. ¿Qué RTO y RPO son aceptables para las tareas que ejecuta?
- Identifique Puntos Únicos de Falla (SPOF): Revise su arquitectura actual de OpenClaw. ¿Hay algún componente (base de datos, nodo, almacenamiento) que, si falla, detendría completamente la operación? Priorice la eliminación de estos SPOF mediante redundancia.
- Defina la Estrategia de Respaldo: Asegúrese de que la base de datos de OpenClaw y los archivos de configuración estén respaldados regularmente y que los respaldos se almacenen de forma segura y replicada. Documente el procedimiento de restauración.
- Bosqueje un Plan de DR: Incluso si es un plan de cold standby, comience a pensar en un sitio de recuperación y cómo restauraría OpenClaw en caso de un desastre mayor. Considere los costos asociados a diferentes niveles de RTO/RPO.
La inversión en HA/DR es una póliza de seguro operativa. Un diseño proactivo evita interrupciones costosas y protege la reputación de la plataforma.
No hay comentarios por ahora.
para ser el primero en comentar.