Integración con Archivos Locales: Carga y Procesamiento de Documentos
La capacidad de cargar documentos locales a ChatGPT es fundamental para el procesamiento de texto. Esta lección cubre cómo integrar archivos, los formatos soportados, y las consideraciones de tamaño y privacidad para optimizar el resumen, análisis y extracción de información.
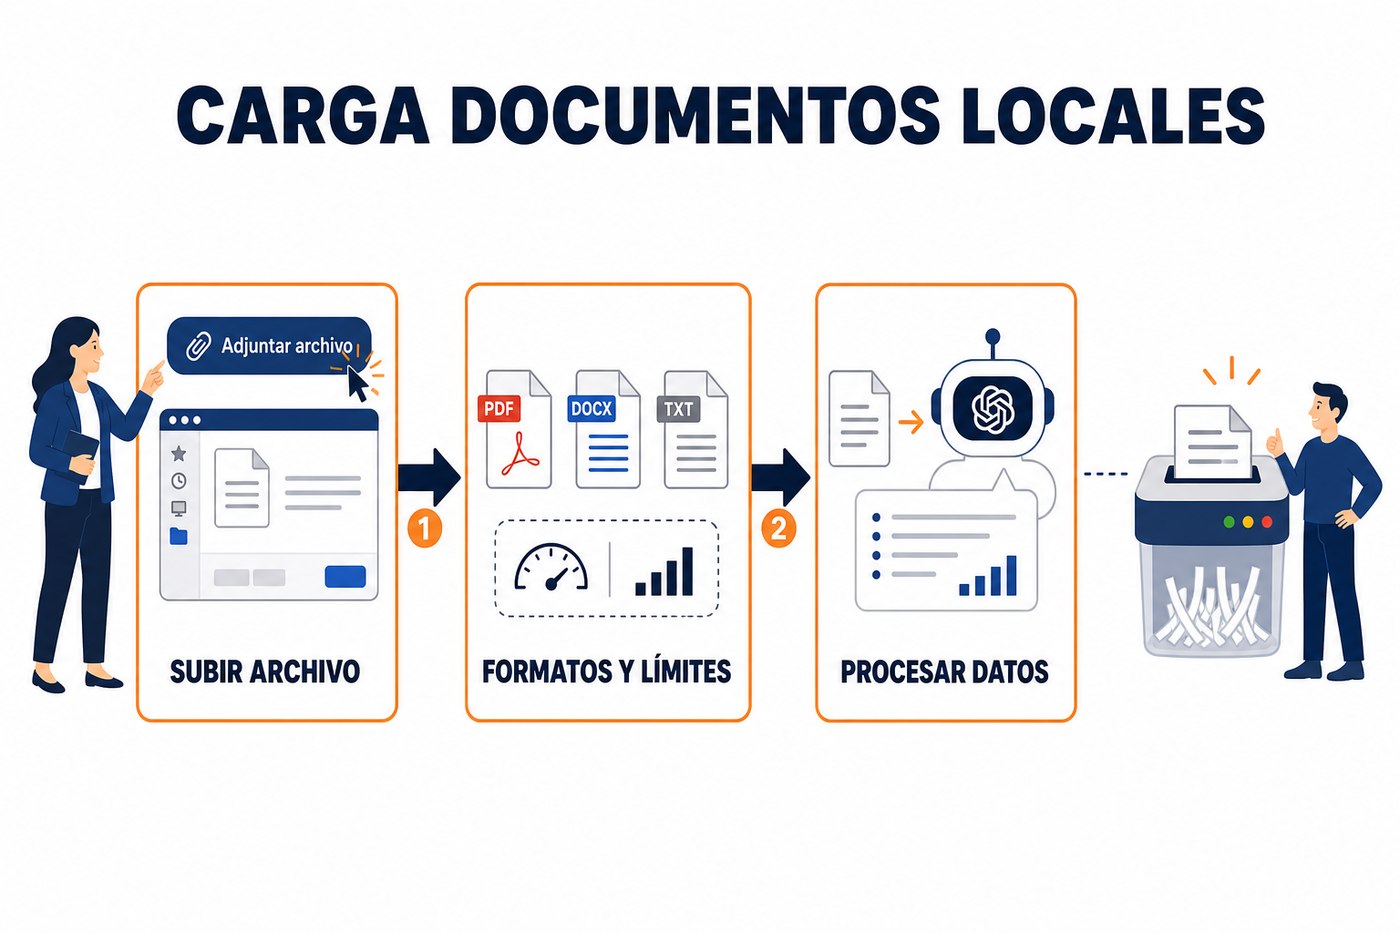
Mecanismo de Carga de Documentos
La aplicación de escritorio de ChatGPT en Windows permite la carga directa de archivos para su procesamiento. Este proceso integra el contenido del documento al contexto de la conversación, habilitando a ChatGPT para interactuar con la información contenida en el archivo. No se trata de una indexación persistente del documento en un sistema de archivos remoto, sino de una carga temporal para la sesión de chat activa.
Para cargar un documento, se utiliza el icono de clip (adjuntar archivo) dentro de la interfaz de chat. Una vez seleccionado el archivo, su contenido se procesa y se añade al contexto. Es crucial entender que la información del documento se envía a los servidores de OpenAI para su procesamiento. Por ello, las políticas de privacidad y uso de datos de OpenAI aplican a todo el contenido cargado.
Formatos Soportados y Límites Técnicos
ChatGPT soporta diversos formatos de archivo de texto y datos estructurados. La capacidad de procesamiento varía según el tipo de suscripción y la versión del modelo, pero los formatos más comunes incluyen:
- Archivos de texto plano (.txt): Ideales para contenido sin formato, como logs, extractos de código o notas.
- Documentos PDF (.pdf): ChatGPT puede extraer texto de PDFs. La calidad de la extracción depende de si el PDF es de texto seleccionable o una imagen escaneada. En este último caso, se aplica OCR (Reconocimiento Óptico de Caracteres), lo que puede introducir errores.
- Documentos de Microsoft Word (.docx): Se extrae el texto principal, ignorando generalmente el formato complejo, imágenes o elementos incrustados.
- Hojas de cálculo (.xlsx, .csv): Utilizados principalmente para análisis de datos, donde ChatGPT puede interpretar columnas y filas para resumir, identificar patrones o generar visualizaciones. (Este punto se profundizará en la siguiente lección).
- Archivos de presentación (.pptx): Similar a .docx, se extrae el texto de las diapositivas.
- Otros formatos de texto: HTML, XML, JSON, Markdown, etc., son procesados como texto plano.
El límite de tamaño de archivo y el número de tokens procesables varían. Generalmente, documentos muy extensos (varias decenas de páginas o megabytes) pueden exceder la ventana de contexto del modelo, resultando en un procesamiento incompleto o errores. Es recomendable dividir documentos grandes o extraer solo las secciones relevantes.
Los límites exactos de tokens no son estáticos y pueden cambiar con las actualizaciones del modelo. Sin embargo, como referencia, los modelos actuales suelen manejar contextos de decenas de miles a cientos de miles de tokens. Un token es aproximadamente 4 caracteres en inglés. Para español, la relación es similar o ligeramente menor.
Estrategias para la Carga y Procesamiento Efectivo
Para maximizar la utilidad de la carga de documentos, considere las siguientes estrategias:
- Pre-procesamiento: Elimine secciones irrelevantes o redundantes del documento antes de cargarlo. Esto reduce el tamaño del archivo y el número de tokens, enfocando el modelo en la información crítica.
- Claridad del Prompt: Después de cargar el documento, el prompt debe ser explícito sobre la tarea. Por ejemplo: "Resume este documento en 200 palabras, enfocándote en las conclusiones principales." o "Extrae todos los requisitos funcionales listados en este archivo y preséntalos como una lista numerada."
- Iteración: Si el resultado no es satisfactorio, refine el prompt o cargue solo secciones específicas del documento para una segunda iteración. Pregunte a ChatGPT qué información encontró o no encontró para ajustar su estrategia.
- Verificación: Siempre verifique la información extraída o resumida contra el documento original. ChatGPT puede cometer errores de interpretación o alucinaciones, especialmente con documentos complejos o ambiguos.
Privacidad y Tratamiento de Datos al Cargar Documentos
La privacidad de los datos es una preocupación crítica al cargar documentos. Al utilizar ChatGPT, el contenido de los archivos se envía a los servidores de OpenAI. Es fundamental entender las implicaciones:
- Uso de Datos para Entrenamiento: Por defecto, OpenAI puede utilizar los datos de las interacciones (incluyendo el contenido de los archivos cargados) para entrenar sus modelos. Esto puede ser deshabilitado en la configuración de la cuenta (Data Controls > Chat History & Training). Para entornos corporativos o datos sensibles, esta opción debe estar deshabilitada.
- Confidencialidad: No se deben cargar documentos que contengan información altamente confidencial, datos personales sensibles (DPC), propiedad intelectual crítica o cualquier dato que no pueda ser expuesto a un tercero. Aunque OpenAI implementa medidas de seguridad, no hay garantía absoluta de que los datos no puedan ser accedidos o expuestos.
- Acuerdos de Nivel de Servicio (SLA): Para uso empresarial, es recomendable revisar los términos de servicio y posibles acuerdos de procesamiento de datos (DPA) con OpenAI. Para la mayoría de los usuarios de la aplicación de escritorio, aplican los términos estándar.
- Jurisdicción: Los datos se procesan en la infraestructura global de OpenAI, que puede estar fuera de México. Esto tiene implicaciones legales y de cumplimiento normativo que deben ser consideradas para datos sujetos a regulaciones específicas.
La precaución es la norma. Si un documento contiene información que bajo ninguna circunstancia debe salir del control de INT, no debe ser cargado a ChatGPT ni a ninguna otra herramienta de IA generativa externa.
Aplicación Práctica: Optimización de Revisión de Documentos
El lunes, utilice la función de carga de documentos para optimizar la revisión de un informe técnico o una propuesta. Seleccione un documento de trabajo que no contenga información confidencial crítica.
- Identifique un documento: Elija un .docx o .pdf de 5-10 páginas de un proyecto actual o pasado (ej. un RFP, un informe de avance, un manual de producto).
- Cargue el documento: Use el icono de clip en ChatGPT y seleccione el archivo.
- Formule prompts específicos: Después de la carga, pida a ChatGPT que realice tareas concretas. Ejemplos:
- "Resume los puntos clave de este informe en tres párrafos."
- "Identifica las tres principales recomendaciones o conclusiones presentadas en este documento."
- "Extrae todos los acrónimos y sus definiciones listadas en el texto."
- "¿Cuáles son los requisitos de hardware mencionados en este documento?"
- Evalúe la respuesta: Compare la salida de ChatGPT con el documento original. Observe la precisión, la exhaustividad y la coherencia. Identifique si el modelo omitió información relevante o si generó texto incorrecto (alucinaciones).
- Experimente con prompts: Intente refinar sus preguntas para obtener mejores resultados. Por ejemplo, si el resumen fue muy general, pida un resumen enfocado en un aspecto específico.
Esta práctica le permitirá familiarizarse con las capacidades y limitaciones de ChatGPT en el procesamiento de documentos, y desarrollar un criterio para su uso eficiente en tareas cotidianas.
No hay comentarios por ahora.
para ser el primero en comentar.