Manejo de errores por nodo y reintentos
El manejo de errores a nivel de nodo es fundamental para construir workflows robustos en n8n. Permite definir cómo reaccionar ante fallos específicos, implementando reintentos automáticos o lógica de fallback para mantener la operación continua y evitar interrupciones innecesarias.
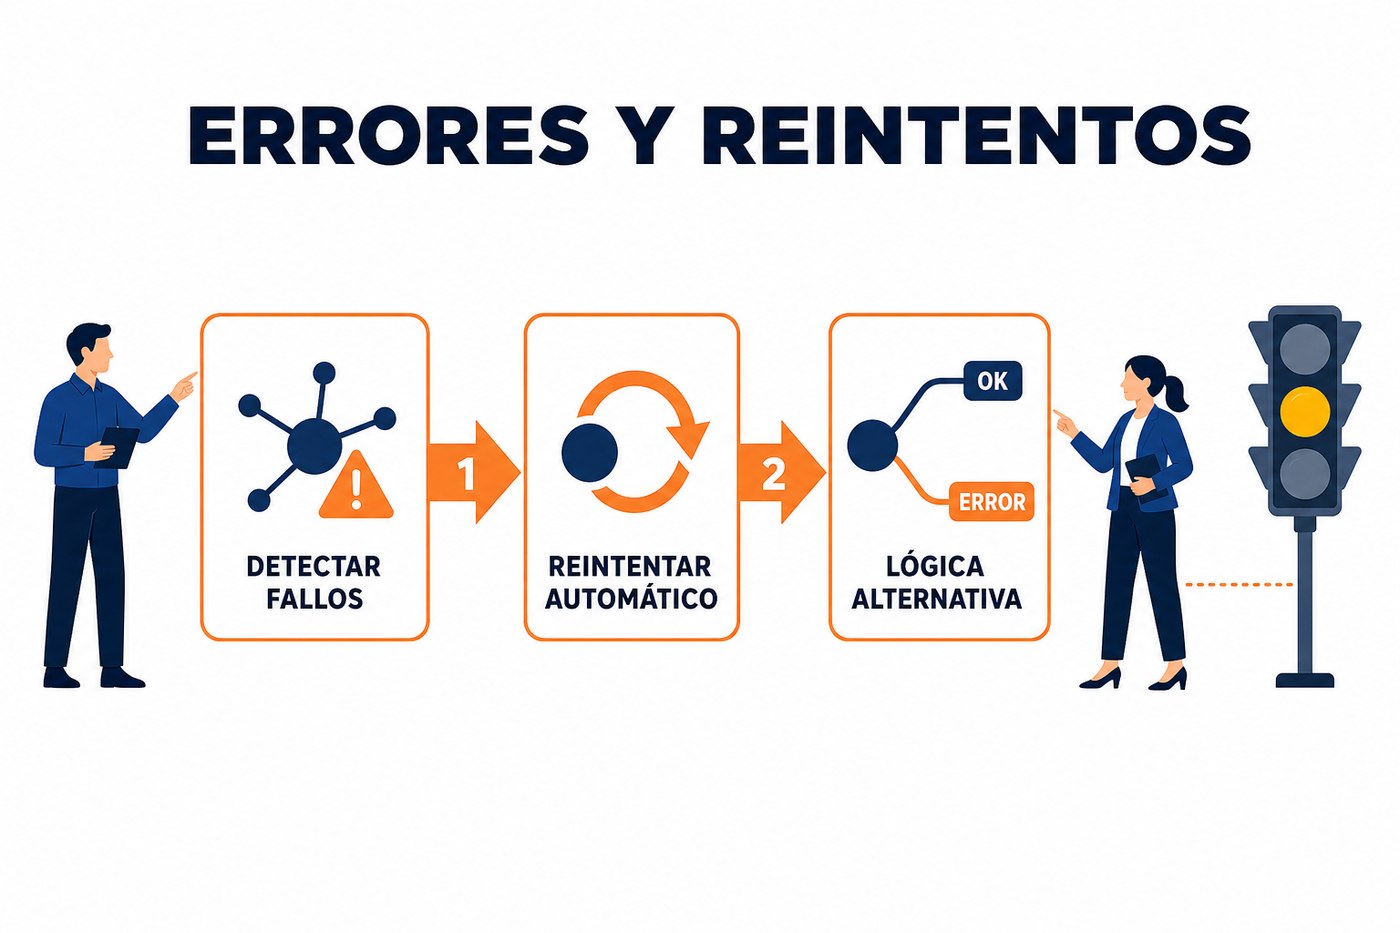
Fundamentos del manejo de errores por nodo
Cada nodo en n8n puede fallar por diversas razones: errores de red, respuestas inesperadas de API, datos inválidos, o límites de tasa. Configurar el manejo de errores a nivel de nodo permite que el workflow reaccione de manera granular a estas situaciones, en lugar de detenerse por completo. Esto es crítico para workflows que interactúan con servicios externos o manejan grandes volúmenes de datos.
La configuración de errores de un nodo se encuentra en la sección 'Error Handling' de su panel de propiedades. Aquí se definen acciones específicas para cuando el nodo no puede procesar su entrada o no obtiene una respuesta válida.
Estrategias de reintento automático
Los reintentos automáticos son la primera línea de defensa contra errores transitorios. Son útiles para situaciones como interrupciones temporales de red, sobrecargas de servicio o límites de tasa puntuales. n8n ofrece varias opciones para configurar reintentos:
- Número de reintentos: Define cuántas veces el nodo intentará ejecutar su operación antes de considerarse un fallo definitivo. Un valor común es 3 a 5 reintentos.
- Retardo entre reintentos: Especifica el tiempo de espera entre cada intento. Es recomendable usar un retardo creciente (exponencial) para dar tiempo a que el servicio se recupere y evitar saturarlo aún más. Por ejemplo, 1s, 2s, 4s.
- Estrategia de reintento: Puede ser fija (mismo retardo siempre) o exponencial (el retardo aumenta con cada intento). La exponencial es preferible para la mayoría de los casos de uso.
- Condición de reintento: Permite especificar bajo qué condiciones el nodo debe reintentar. Por ejemplo, solo reintentar si el código de estado HTTP es 5xx (errores del servidor) pero no 4xx (errores del cliente).
Configurar reintentos con una estrategia exponencial es una buena práctica para APIs externas. Un retardo inicial de 1-2 segundos y un multiplicador de 2 suele ser efectivo. Limitar el número total de reintentos a 5-7 evita que el workflow se quede atascado en un bucle infinito de intentos fallidos.
Ejemplo de configuración de reintentos para un nodo HTTP Request:
{
  "retryOnFail": true,
  "retryAttempts": 5,
  "retryDelay": 1000,
  "retryDelayFactor": 2,
  "retryOnHttpCodes": [500, 502, 503, 504]
}
Lógica de fallback y ramificación de errores
Cuando los reintentos no son suficientes, la lógica de fallback permite que el workflow siga una ruta alternativa. Esto se logra conectando un nodo de 'Error' (o cualquier otro nodo) directamente desde la salida de error de un nodo. La salida de error de un nodo se activa cuando el nodo falla después de todos sus reintentos configurados.
Las principales aplicaciones de la lógica de fallback son:
- Notificación: Enviar un mensaje a un canal de Slack, correo electrónico o sistema de monitoreo informando sobre el fallo.
- Registro: Guardar los detalles del error en una base de datos o archivo para análisis posterior.
- Procesamiento alternativo: Intentar una operación diferente. Por ejemplo, si una API primaria falla, intentar con una API secundaria o usar datos preestablecidos.
- Finalización controlada: Terminar el workflow de manera controlada, quizás marcando el ítem como fallido en un sistema externo.
Para implementar esto, arrastre una conexión desde el puerto rojo de 'Error' del nodo fallido hacia el nodo que gestionará el fallback. El nodo de fallback recibirá los datos del ítem que causó el error, junto con la información detallada del fallo.
Acceso a la información del error
Cuando un nodo falla y su salida de error se activa, el siguiente nodo conectado a esta salida recibe un objeto de error. Este objeto contiene detalles cruciales para diagnosticar y manejar el problema. Los datos del error son accesibles a través de expresiones.
{{ $json.error.name }}: Tipo de error (ej. 'NodeExecuteError').{{ $json.error.message }}: Mensaje descriptivo del error.{{ $json.error.stack }}: Pila de llamadas (stack trace) que muestra dónde ocurrió el error.{{ $json.error.itemIndex }}: Índice del ítem que causó el error en la entrada del nodo.{{ $json.error.node.name }}: Nombre del nodo que falló.{{ $json.error.node.id }}: ID del nodo que falló.
Utilizar esta información en nodos de notificación o registro permite crear mensajes de alerta claros y accionables.
Consideraciones de idempotencia
Al implementar reintentos, es vital considerar la idempotencia de las operaciones. Una operación es idempotente si ejecutarla múltiples veces produce el mismo resultado que ejecutarla una sola vez. Si una operación no es idempotente y se reintenta, podría causar efectos secundarios no deseados (ej. crear registros duplicados, enviar el mismo correo varias veces).
- Operaciones idempotentes: Actualizar un registro existente, eliminar un recurso (si la eliminación de un recurso inexistente no causa error).
- Operaciones no idempotentes: Crear un nuevo registro sin un identificador único, enviar un correo electrónico, procesar un pago.
Si una operación no es idempotente, los reintentos deben usarse con precaución o combinarse con mecanismos para garantizar que la operación no se duplique. Esto a menudo implica verificar el estado antes de reintentar o usar identificadores de idempotencia proporcionados por la API externa.
Aplicación práctica: Configurando un nodo de API
El lunes, al configurar un nodo HTTP Request que interactúa con un servicio externo, sigue estos pasos:
- Abre las propiedades del nodo y ve a la sección 'Error Handling'.
- Habilita 'Retry on Fail'.
- Configura 'Retry Attempts' a 5.
- Establece 'Retry Delay' a 1000 ms (1 segundo) y 'Retry Delay Factor' a 2. Esto implementará un retardo exponencial.
- En 'Retry on HTTP Codes', añade 500, 502, 503, 504. Esto asegura que solo se reintente en errores del servidor, no en errores de cliente (como 400 o 404).
- Conecta el puerto de error rojo del nodo a un nodo 'Send Email' o 'Send Telegram' para notificar al equipo si el nodo falla después de todos los reintentos. En el mensaje de notificación, incluye
{{ $json.error.message }}y{{ $json.error.node.name }}para un diagnóstico rápido.
No hay comentarios por ahora.
para ser el primero en comentar.