Medición y optimización de la latencia
La latencia es un factor crítico en la experiencia del usuario y la eficiencia operativa de los agentes LangGraph. Entender sus componentes y aplicar estrategias de optimización es fundamental para el despliegue en producción. Esta lección aborda cómo identificar cuellos de botella y reducir los tiempos de respuesta.
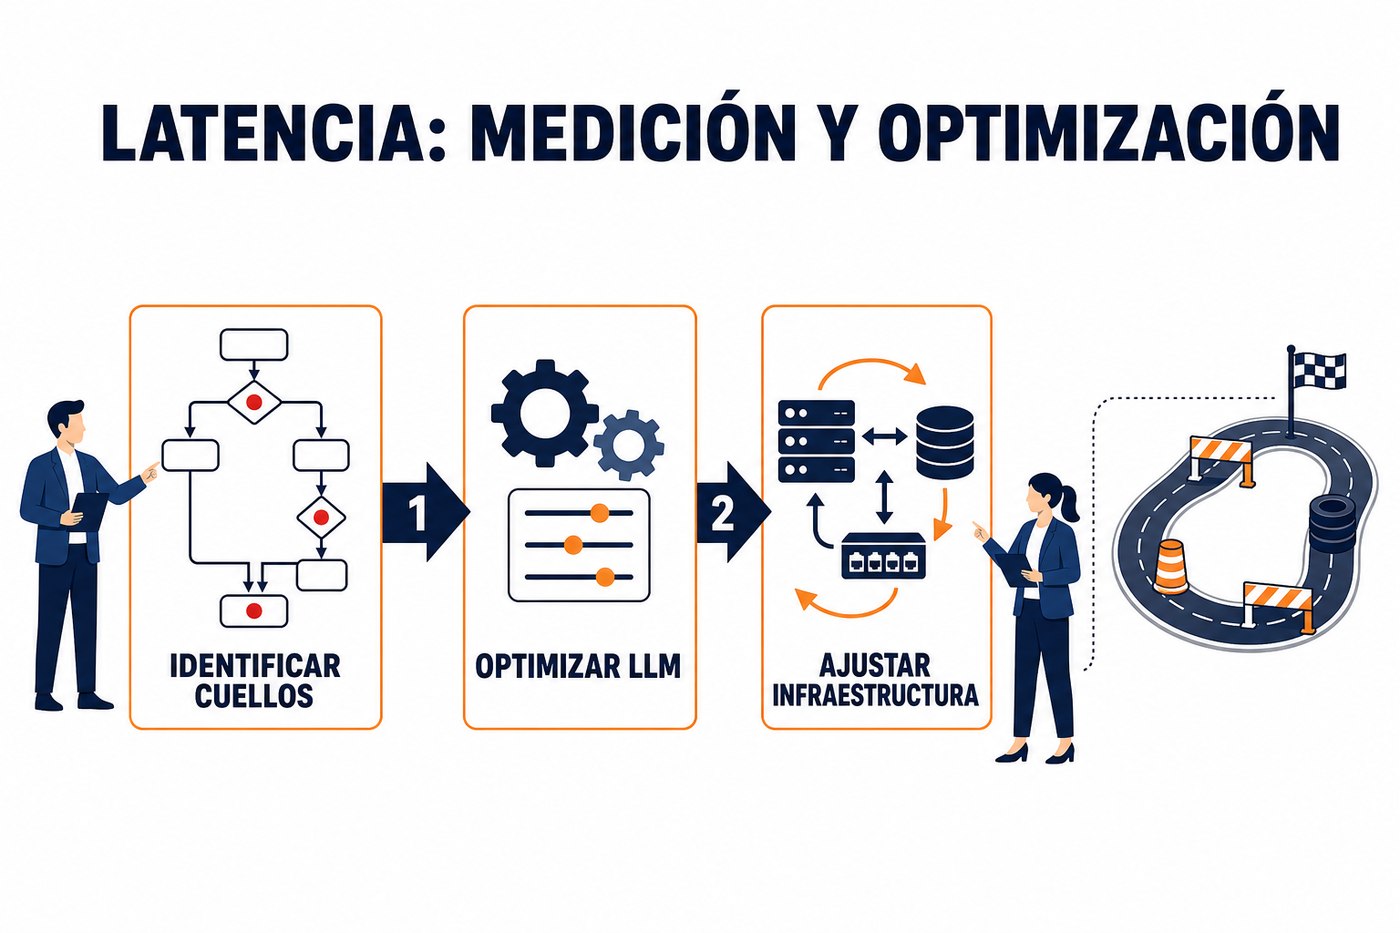
Componentes de la latencia en LangGraph
La latencia total de una ejecución de LangGraph se compone de varios factores. Identificar cuál o cuáles dominan es el primer paso para la optimización. Estos componentes incluyen:
- Latencia de la API del LLM: Tiempo que tarda el proveedor del Modelo de Lenguaje Grande (LLM) en procesar la solicitud y devolver una respuesta. Esto incluye el tiempo de red y el tiempo de inferencia del modelo.
- Latencia de herramientas externas: Tiempo que tardan las llamadas a herramientas (APIs, bases de datos, servicios web) en ejecutarse y devolver resultados.
- Latencia de procesamiento local: Tiempo que el grafo de LangGraph dedica a la lógica interna, como la manipulación de estados, el enrutamiento de nodos, la serialización/deserialización y la ejecución de funciones Python locales.
- Latencia de red interna: Tiempo de comunicación entre los componentes del sistema (por ejemplo, entre el servicio que ejecuta LangGraph y un servicio de herramientas o una base de datos local).
La observabilidad, como se vio en lecciones anteriores, es clave para desglosar estos tiempos. Herramientas como LangSmith permiten visualizar las trazas y los tiempos de cada paso, nodo y llamada externa.
Estrategias de optimización para la latencia del LLM
La latencia del LLM suele ser el componente más significativo. Las opciones para mitigarla son:
- Selección de modelos: Modelos más pequeños o diseñados para baja latencia (por ejemplo, modelos optimizados para inferencia rápida) pueden ser una alternativa. Evaluar el trade-off entre capacidad y velocidad es crucial.
- Streaming: Configurar las llamadas al LLM para usar streaming permite que el agente comience a procesar la respuesta tan pronto como los primeros tokens estén disponibles, en lugar de esperar la respuesta completa. Esto mejora la percepción del usuario, aunque el tiempo total de la API puede no cambiar drásticamente.
- Paralelización: Si el grafo permite ejecutar múltiples llamadas al LLM o a herramientas de forma independiente, la ejecución concurrente puede reducir el tiempo total. LangGraph soporta ejecución paralela de nodos.
- Caché: Implementar una capa de caché para las respuestas del LLM o de herramientas, cuando las entradas son repetitivas, puede eliminar llamadas externas y reducir drásticamente la latencia. Esto es especialmente útil para consultas frecuentes con respuestas estáticas o semiestáticas.
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, END

# Modelo configurado para streaming
llm_streaming = ChatOpenAI(model="gpt-4o", streaming=True)

# Ejemplo de nodo que usa streaming (conceptual)
def call_llm_node(state):
    response = []
    for chunk in llm_streaming.stream(state["input"]):
        response.append(chunk.content)
    return {"output": "".join(response)}

# ... integración en el grafoLa elección entre un LLM de alta capacidad y uno de baja latencia debe basarse en el requisito funcional primario. Para tareas críticas donde la velocidad de respuesta es vital (ej. chatbots conversacionales en tiempo real), priorizar la latencia es correcto, incluso si implica un ligero compromiso en la profundidad de la respuesta. Para tareas de análisis complejo, la precisión puede justificar una mayor latencia.
Optimización de herramientas y procesamiento local
Las herramientas externas y la lógica interna también pueden ser fuentes de latencia. Las acciones para optimizar incluyen:
- Optimización de herramientas: Asegurar que las APIs externas sean eficientes. Esto puede implicar optimizar consultas a bases de datos, reducir la complejidad de las APIs o usar versiones más rápidas de servicios. La telemetría de las herramientas es indispensable.
- Ejecución asíncrona: Utilizar funciones asíncronas (
async/await) para llamadas a herramientas o LLMs que lo soporten. LangGraph está diseñado para manejar flujos asíncronos, lo que permite que el grafo no se bloquee mientras espera respuestas I/O. - Reducción de nodos: Simplificar el grafo eliminando nodos redundantes o combinando lógica donde sea posible. Cada transición y procesamiento de estado añade un pequeño overhead.
- Serialización/Deserialización: Minimizar la cantidad de datos que se serializan y deserializan entre nodos, especialmente si se usan formatos complejos o grandes objetos. Mantener el estado lo más ligero posible.
Infraestructura y despliegue
La infraestructura subyacente juega un papel crucial en la latencia general del sistema.
- Proximidad geográfica: Desplegar el agente LangGraph y sus herramientas cerca de los usuarios finales o de los servicios de LLM puede reducir la latencia de red.
- Recursos computacionales: Asegurar que el entorno de ejecución (CPU, memoria) tenga recursos suficientes para manejar la carga esperada. Un servidor subdimensionado ralentizará el procesamiento local.
- Contenedorización y orquestación: Utilizar contenedores (Docker) y orquestadores (Kubernetes) permite escalar horizontalmente el servicio de LangGraph para manejar picos de demanda, distribuyendo la carga y manteniendo la latencia baja.
- Conexiones persistentes: Para llamadas a APIs o bases de datos, el uso de connection pools puede reducir la sobrecarga de establecer nuevas conexiones para cada solicitud.
Aplicación práctica: ¿Qué hacer el lunes?
- Revisar trazas de LangSmith: Analice las trazas de ejecuciones recientes de su agente en LangSmith. Identifique los nodos y las llamadas a herramientas que consumen más tiempo. Busque patrones de latencia elevada en llamadas repetitivas.
- Experimentar con modelos LLM: Si el LLM es el cuello de botella, pruebe con un modelo alternativo más pequeño o con una configuración de streaming. Mida el impacto en la latencia y en la calidad de la respuesta.
- Optimizar herramientas: Colabore con los equipos responsables de las APIs o servicios externos para identificar y resolver cuellos de botella en esas herramientas. Implemente cachés si las llamadas son repetitivas.
- Refactorizar nodos críticos: Si hay nodos con lógica Python compleja o manipulación intensiva de estado, evalúe si pueden simplificarse o ejecutarse de manera más eficiente (ej. con
async/await). - Monitorear la infraestructura: Verifique que los recursos de CPU y memoria del servidor donde se ejecuta LangGraph son adecuados para la carga actual y proyectada. Considere un plan de escalabilidad.
No hay comentarios por ahora.
para ser el primero en comentar.