Desafíos de la Inferencia a Escala
El despliegue de modelos de IA en producción presenta desafíos operativos significativos. Esta lección aborda los retos clave de la inferencia a escala, incluyendo la gestión de recursos, la latencia y el throughput, elementos críticos para el éxito de cualquier implementación de IA.
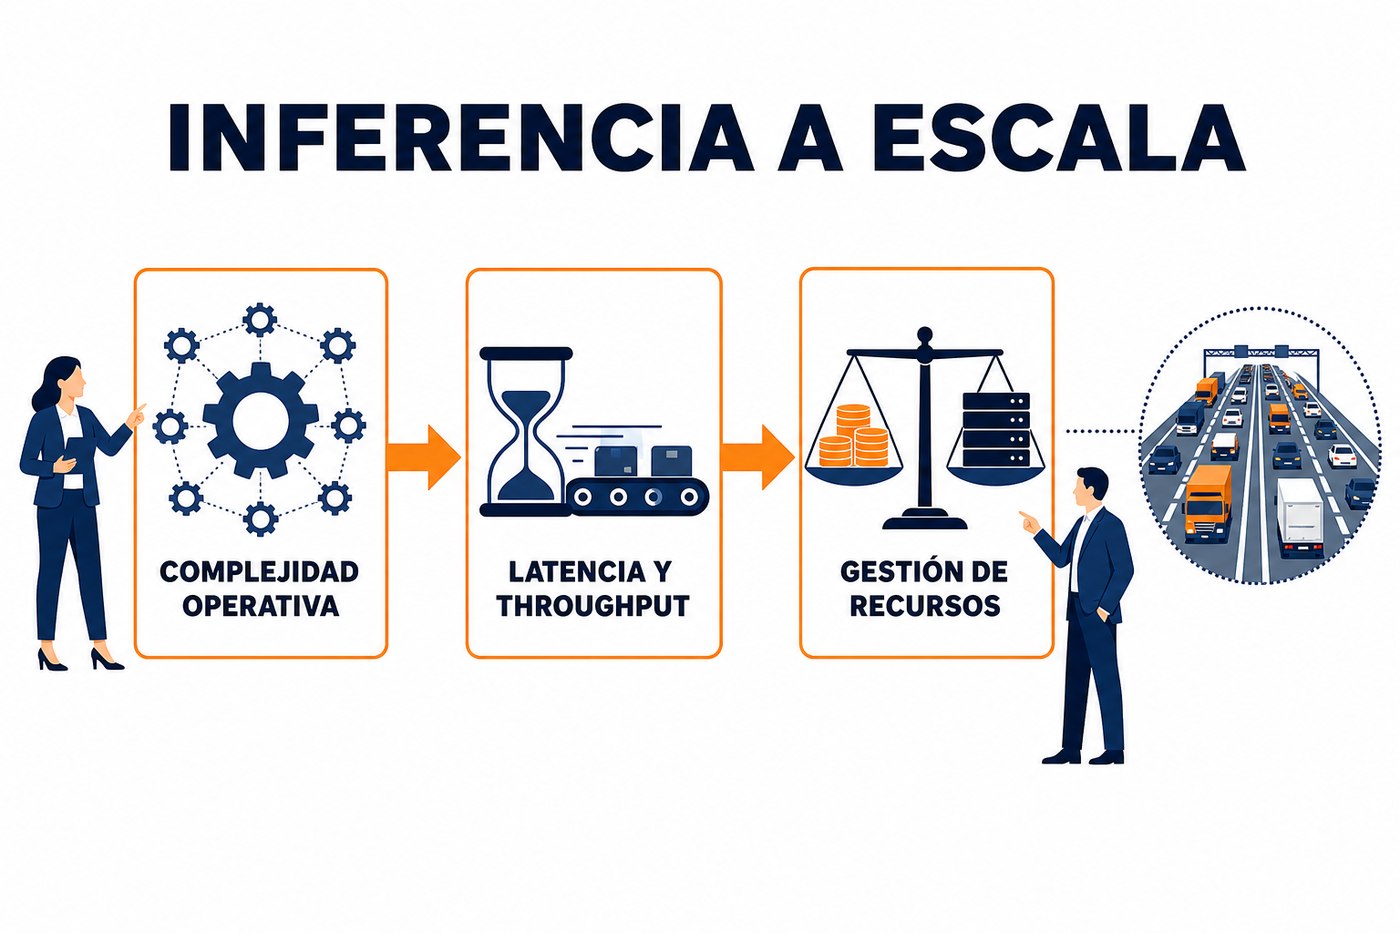
La Complejidad de la Inferencia en Producción
Desplegar un modelo de IA entrenado es solo la mitad del proceso. La inferencia, es decir, la aplicación del modelo a datos nuevos para generar predicciones o clasificaciones, debe ejecutarse de manera eficiente, confiable y a menudo en tiempo real. Esto implica considerar no solo la precisión del modelo, sino también su capacidad para manejar volúmenes de solicitudes, la velocidad de respuesta y el uso óptimo de la infraestructura. La transición de un entorno de desarrollo a uno de producción expone limitaciones y dependencias que no son evidentes durante el entrenamiento o la validación inicial.
Latencia: Velocidad de Respuesta Crítica
La latencia se refiere al tiempo que transcurre desde que se envía una solicitud de inferencia hasta que se recibe la respuesta. En muchos casos de uso, una baja latencia es fundamental. Por ejemplo:
- Sistemas de recomendación en línea: Una latencia alta impacta negativamente la experiencia del usuario y las conversiones.
- Detección de fraude en transacciones: Retrasos significativos pueden invalidar la utilidad de la detección en tiempo real.
- Visión por computadora en vehículos autónomos: Una latencia inaceptable tiene consecuencias de seguridad directas.
- Procesamiento de Lenguaje Natural (PLN) en asistentes virtuales: La fluidez de la conversación depende de respuestas rápidas.
La latencia no solo es el tiempo de cómputo del modelo, sino que incluye el tiempo de preparación de la entrada, la transferencia de datos a la GPU, la ejecución del modelo, la transferencia de resultados de regreso y el post-procesamiento. Optimizar cada etapa es crucial para reducir la latencia total. Un modelo más grande o complejo generalmente implica mayor latencia. La elección de hardware, el diseño del modelo y la estrategia de despliegue influyen directamente en este métrico.
Throughput: Capacidad de Procesamiento por Unidad de Tiempo
El throughput (rendimiento) es la cantidad de solicitudes de inferencia que un sistema puede procesar en un período determinado, usualmente medido en inferencias por segundo (IPS). Mientras la latencia se enfoca en la respuesta individual, el throughput se centra en la capacidad agregada del sistema. Un alto throughput es vital cuando se manejan grandes volúmenes de datos o un número elevado de usuarios concurrentes. Por ejemplo, un servicio de traducción automática que atiende a millones de usuarios simultáneamente necesita un throughput masivo.
Optimizar el throughput a menudo implica técnicas como el batching, donde múltiples solicitudes de inferencia se agrupan y se procesan juntas en un solo pase a través del modelo. Esto aprovecha la paralelización inherente de las GPU, pero puede introducir un compromiso con la latencia, ya que las solicitudes individuales deben esperar a que se acumule un batch. Encontrar el tamaño de batch óptimo es un balance entre latencia y throughput.
No se puede optimizar simultáneamente la latencia al mínimo y el throughput al máximo con los mismos recursos. La optimización es un compromiso: priorice uno sobre el otro según el requisito operativo principal del caso de uso. Un sistema de detección de intrusiones en tiempo real prioriza latencia; un sistema de análisis de sentimientos de comentarios masivos prioriza throughput.
Gestión de Recursos y Costos
Los modelos de IA, especialmente los grandes modelos de lenguaje (LLM) o los modelos de visión por computadora, son intensivos en recursos de cómputo, particularmente GPU y memoria VRAM. La gestión eficiente de estos recursos es fundamental para controlar los costos operativos y garantizar la disponibilidad del servicio. Los desafíos incluyen:
- Asignación de GPU: Determinar cuántas y qué tipo de GPU se necesitan para un modelo específico, considerando su tamaño, complejidad y la carga esperada.
- Uso de VRAM: Los modelos grandes pueden consumir gigabytes de memoria de video. Múltiples modelos o múltiples instancias de un mismo modelo pueden competir por esta memoria.
- Escalabilidad: La capacidad de escalar los recursos de cómputo (GPU) hacia arriba o hacia abajo dinámicamente en respuesta a la demanda, para evitar el sobreaprovisionamiento (costoso) o el subaprovisionamiento (impacto en el servicio).
- Costos: Las GPU son componentes costosos, tanto en adquisición (on-premise) como en alquiler (nube). La eficiencia en su uso se traduce directamente en ahorro.
La gestión de recursos también implica la orquestación de contenedores, el balanceo de carga y la automatización del despliegue para mantener la operatividad y la resiliencia del sistema.
Aplicación Práctica: Evaluación de Requerimientos Operativos
Para el lunes, al planificar cualquier despliegue de inferencia de IA, es crítico definir explícitamente los requerimientos operativos antes de seleccionar la arquitectura o el hardware. Responda a las siguientes preguntas clave:
- ¿Cuál es la latencia máxima aceptable para una sola inferencia? (Ej. 100 ms, 1 segundo).
- ¿Cuál es el throughput mínimo requerido durante los picos de demanda? (Ej. 1000 inferencias/segundo).
- ¿Cuál es el volumen de datos de entrada por solicitud y el tamaño del modelo en VRAM?
- ¿Cuáles son las expectativas de concurrencia (número de usuarios o solicitudes simultáneas)?
- ¿Existe un presupuesto de costos definido para la infraestructura de inferencia?
Documentar estas métricas y limitaciones ayudará a justificar las decisiones de diseño y a evaluar las soluciones tecnológicas, como NVIDIA NIM, que abordaremos en la próxima lección.
No hay comentarios por ahora.
para ser el primero en comentar.