Monitoreo y Observabilidad de Despliegues NIM
El monitoreo y la observabilidad son esenciales para garantizar la disponibilidad y el rendimiento de los despliegues de NVIDIA NIM. Esta lección cubre las herramientas y prácticas para seguir el estado, la utilización de recursos y el rendimiento de los servicios de inferencia, permitiendo identificar y resolver problemas proactivamente.
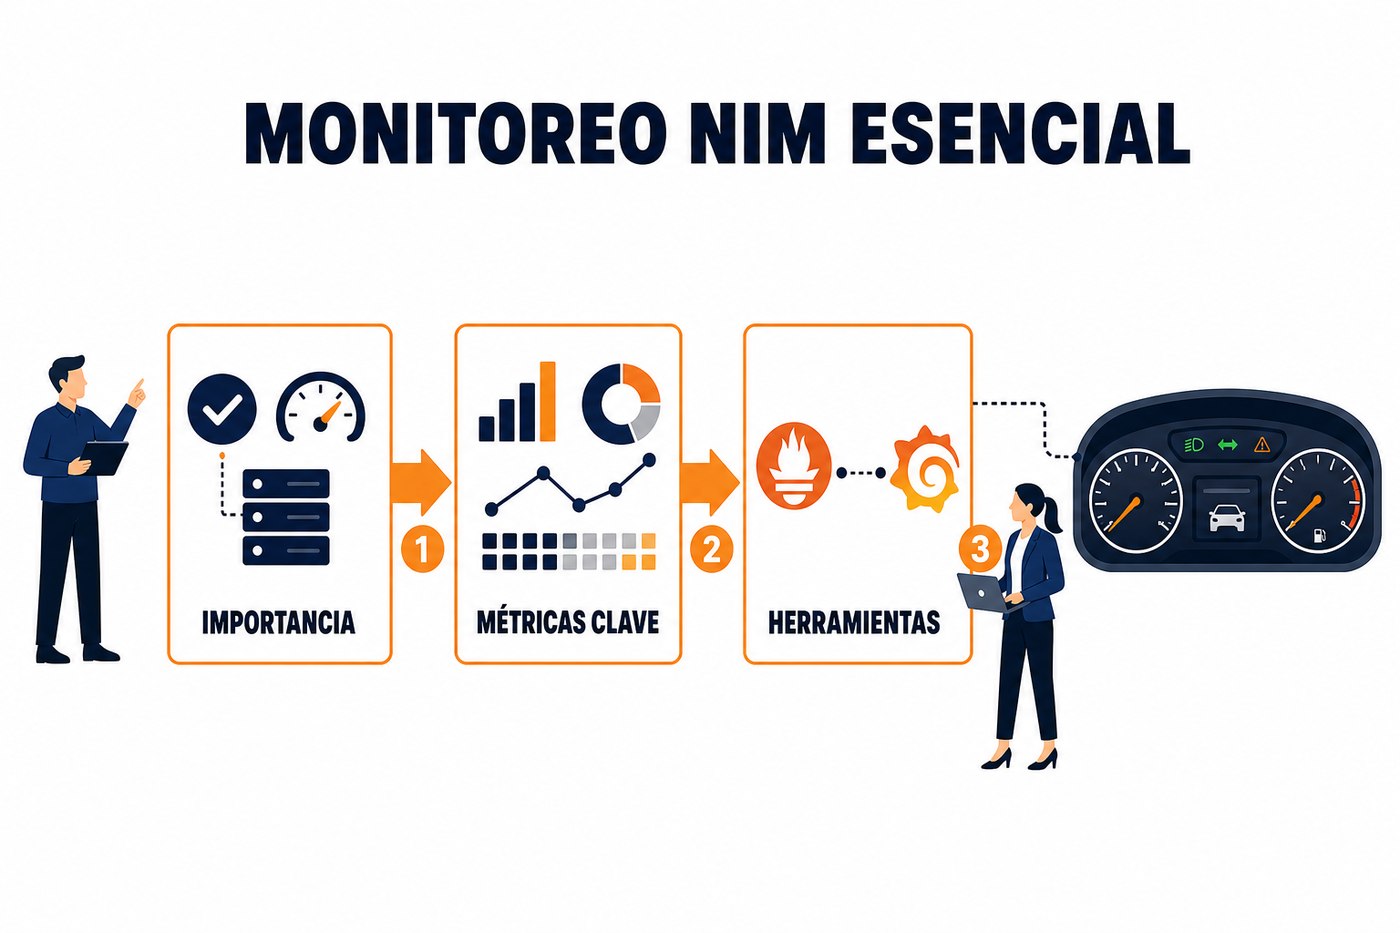
Importancia del Monitoreo en NIM
Los microservicios NIM encapsulan modelos de inferencia, y su despliegue implica recursos de GPU, CPU y memoria. Sin un monitoreo adecuado, es difícil identificar cuellos de botella, predecir fallas o entender el comportamiento del sistema bajo carga. Un monitoreo efectivo permite: detectar anomalías, optimizar la asignación de recursos, planificar la capacidad y asegurar que los acuerdos de nivel de servicio (SLA) se cumplan.
Métricas Clave a Monitorear
Para los despliegues de NIM, se deben recolectar métricas de tres categorías principales: sistema, microservicio y modelo.
- Métricas de Sistema (Host/GPU):
- Utilización de GPU: Porcentaje de tiempo que la GPU está activa procesando cargas de trabajo. Un valor consistentemente alto puede indicar saturación.
- Uso de memoria de GPU: Cantidad de memoria de video utilizada por los procesos. Es crítica para evitar errores de falta de memoria (OOM).
- Utilización de CPU: Carga de los núcleos de CPU del host. Aunque la inferencia es intensiva en GPU, la CPU gestiona el sistema operativo y el orquestador de contenedores.
- Uso de memoria RAM del host: Memoria principal utilizada por el sistema y los contenedores.
- E/S de disco y red: Rendimiento de entrada/salida para carga de modelos y comunicación entre servicios.
- Métricas de Microservicio (NIM):
- Latencia de inferencia: Tiempo total que tarda una solicitud en ser procesada, desde que llega al microservicio hasta que se envía la respuesta. Se debe monitorear el promedio, percentiles (p50, p90, p99).
- Throughput (RPS/QPS): Número de solicitudes por segundo (Requests Per Second / Queries Per Second) que el microservicio puede manejar. Indica la capacidad de procesamiento.
- Errores: Tasa de respuestas con códigos de error (ej. 5xx HTTP). Un aumento repentino indica problemas.
- Conexiones activas: Número de clientes concurrentes. Útil para entender la carga.
- Métricas de Modelo:
- Sesgos del modelo: Desviaciones en las predicciones del modelo con el tiempo. Requiere monitorear las entradas y salidas del modelo.
- Drift de datos: Cambios en la distribución de los datos de entrada en comparación con los datos de entrenamiento. Puede degradar la precisión del modelo.
Herramientas de Monitoreo Comunes
Para recolectar y visualizar estas métricas, se utilizan herramientas estándar de la industria. NVIDIA NIM, al ser desplegado en contenedores, se integra bien con el ecosistema de monitoreo de Kubernetes y Docker.
- Prometheus: Sistema de monitoreo y alerta de código abierto. Recolecta métricas de objetivos configurados a través de un modelo pull. Es la opción estándar para entornos de contenedores.
- Grafana: Plataforma de visualización y análisis. Se integra con Prometheus para crear dashboards interactivos que muestran el estado y rendimiento de los despliegues NIM.
- NVIDIA DCGM (Data Center GPU Manager): Herramienta de línea de comandos y biblioteca para monitorear el estado y rendimiento de las GPU NVIDIA. Exporta métricas que pueden ser recolectadas por Prometheus a través de un exportador.
- cAdvisor: Agente que recolecta información de rendimiento y uso de recursos de contenedores. Integrado en Kubernetes.
- Alertmanager: Componente de Prometheus que gestiona las alertas, las agrupa y las envía a los canales configurados (ej. correo electrónico, Slack).
No dependa solo de las métricas de CPU/RAM del host. Las GPU tienen su propio conjunto de métricas críticas que deben ser monitoreadas con herramientas específicas como DCGM. Una GPU subutilizada o con memoria saturada puede ser el cuello de botella, incluso si la CPU del host parece normal.
Configuración Básica de Monitoreo con Prometheus y Grafana
Para monitorear un microservicio NIM, se debe asegurar que el contenedor exporte métricas en un formato legible por Prometheus (generalmente en el endpoint /metrics). Los contenedores NIM de NVIDIA suelen exponer estas métricas automáticamente o a través de configuraciones. Un ejemplo de configuración de Prometheus para raspar un endpoint de métricas sería:
scrape_configs:
  - job_name: 'nvidia-nim-inference'
    static_configs:
      - targets: ['<IP_DEL_NIM_SERVICE>:8000'] # Reemplazar con la IP y puerto del servicio NIM
    metrics_path: /metrics
Luego, en Grafana, se configura Prometheus como fuente de datos y se construyen paneles con consultas PromQL para visualizar las métricas recolectadas. Por ejemplo, para ver la utilización de GPU:
nvidia_gpu_utilization_gpu_percent{job="nvidia-nim-inference"}Para la latencia de inferencia, se pueden usar métricas de histograma o resúmenes expuestas por el microservicio.
Observabilidad y Logging
Más allá de las métricas, la observabilidad requiere logs y trazas. Los logs proporcionan un registro detallado de eventos y errores dentro del microservicio NIM. Deben ser centralizados y accesibles para análisis. Herramientas como ELK Stack (Elasticsearch, Logstash, Kibana) o Grafana Loki son comunes para la gestión de logs.
Las trazas distribuidas (ej. con OpenTelemetry) permiten seguir el flujo de una solicitud a través de múltiples servicios. Esto es menos crítico para un único microservicio NIM, pero se vuelve esencial en arquitecturas complejas donde el NIM es parte de una cadena de inferencia más grande. Permite identificar dónde se introduce la latencia en la ruta completa de la solicitud.
Aplicación Práctica: Qué Hacer el Lunes
- Verificar exposición de métricas: Asegúrese de que sus despliegues de microservicios NIM estén exponiendo métricas en un endpoint
/metrics. Consulte la documentación de NVIDIA para la versión específica de NIM que esté utilizando. - Configurar Prometheus: Si no tiene uno, despliegue una instancia de Prometheus en su entorno. Configure un
scrape_configpara recolectar métricas de sus servicios NIM y de las GPU subyacentes (usando DCGM exporter). - Crear Dashboards en Grafana: Instale Grafana y configúrelo con Prometheus como fuente de datos. Cree un dashboard inicial con paneles para: utilización de GPU, uso de memoria de GPU, latencia de inferencia (p50, p90, p99) y throughput (RPS).
- Establecer Alertas Básicas: Configure alertas en Prometheus/Alertmanager para: alta utilización de GPU (>90% por X minutos), bajo throughput (indicando fallas), y alta tasa de errores (ej. >5% de solicitudes).
- Centralizar Logs: Asegure que los logs de los contenedores NIM se envíen a un sistema de gestión de logs centralizado (ej. ELK, Loki) para facilitar la depuración.
No hay comentarios por ahora.
para ser el primero en comentar.